

AI 一天一个样,概念越来越多,光看标题就开始累。《听懂 AI》是一档中文对谈播客,主持人和嘉宾一问一答,把那些听起来很厉害的 AI 进展,拆成你下班路上就能听懂的人话。每期十分钟,听完跟得上。

TL;DR:AI 已经能预测蛋白结构、筛选化合物、几秒内生成候选分子,但合成、细胞实验、动物研究和人体临床仍受生物学规律与监管要求约束——AI 加速的是研发前端搜索,而不是整条新药研发流程。这一判断来自 Andreas Bender 等人 2026 年 8 月 7 日发表于 Nature Reviews Drug Discovery 的观点文章。
AI 已经能预测蛋白结构、筛选化合物、生成候选分子,也能辅助预测活性和毒性。计算端的进步很快,但一款药物是否安全、有效,最后仍要由实验和人体数据回答。
候选分子可以在几秒或几小时内生成。合成、细胞实验、动物研究和人体临床却受生物学规律、实验条件、患者差异与监管要求约束。前端搜索加速,并不会让整条研发流程按同样比例缩短。
🎬 视频版(B站) | 🎧 音频版(5 分 29 秒)| 🟢 Spotify 订阅 | 📖 偏好阅读?文字版就在下方 👇
AI 在药物研发中已经能做什么
目前常见应用包括:
- 从疾病机制和多组学数据中寻找潜在靶点;
- 预测蛋白质结构和分子相互作用;
- 在化合物库中做虚拟筛选;
- 生成新的候选分子;
- 预测活性、选择性、药代动力学或毒性相关性质;
- 辅助实验设计、数据分析和文献整理。
AlphaFold 在 2021 年的 CASP14 评测中显著提高了蛋白结构预测准确度,是计算方法改变生命科学工具链的明确案例。但蛋白结构只是药物研发需要处理的一类信息。知道一个蛋白大致长什么样,不等于已经找到了能安全治疗患者的药。
候选分子与药物之间隔着什么
FDA 对药物研发流程的说明列出了候选物之后仍需回答的问题:它怎样被人体吸收、分布、代谢和排泄;合适剂量是多少;可能出现哪些毒性和药物相互作用;不同人群的反应是否不同。
临床前研究只能回答一部分安全问题,不能替代人体研究。进入临床后,研究者还要分阶段评估剂量、安全性、初步疗效、治疗获益和少见不良反应。临床试验使用明确的方案、入组标准、对照和统计方法,计算模型不能跳过这些证据要求。
AI 如果只把早期筛选从一个月缩短到一天,而合成、验证或临床仍是主要瓶颈,患者拿到药物的时间就不会同步缩短。
生命科学数据为什么特别依赖条件
同一个分子在不同实验方法、细胞系统、剂量、时间点和患者群体中,可能表现不同。训练数据中的“有效”,也许只表示它在某个测试中与靶点结合,并不自动包含能否进入细胞、到达正确组织、避免伤害其他器官等信息。
数据还可能来自不同实验室、设备和记录标准。模型在随机拆分的测试集上表现很好,可能只是因为训练集和测试集共享了相似化合物、实验条件或研究习惯。换到新时间、新项目或新实验室后,性能未必保持。
因此,模型分数需要和适用范围一起解释。脱离实验条件的单一“准确率”,很难代表真实研发决策的可靠性。
“有效分子”本身可能没有定义完整
原文把这种问题称为 underspecification,即任务看起来已经定义,实际仍遗漏了决定结果的条件。
例如,“预测一个有效分子”至少可能指:
- 能与目标蛋白结合;
- 在细胞中改变预期通路;
- 能到达需要作用的组织;
- 在有效剂量下没有不可接受的毒性;
- 对目标患者群体产生可测量的治疗获益。
这些目标不能互相替代。模型可能准确优化了容易取得的代理指标,却没有优化项目最后真正关心的结果。此时增加模型规模或生成更多分子,只会让不合适的目标被执行得更快。
benchmark 应该评价模型,还是评价决策
Nature Reviews 的观点文章认为,药物研发中的 benchmark 需要从模型验证转向决策价值。团队不应只问预测误差有没有下降,还要问:
- 原本会继续投入的坏候选,是否更早被淘汰;
- 原本会错过的好方向,是否被模型发现;
- 实验数量、时间和成本是否减少;
- 换到未来数据、外部实验室和新项目后,判断是否仍可靠;
- 候选进入下一阶段后的失败率是否改变。
一个模型可以在静态数据集上领先,却没有改变任何 go/no-go 决定。反过来,一个不够耀眼的工具如果能稳定减少无效实验,可能更有实际价值。
“技术推动”和“科学问题牵引”有什么区别
技术推动通常从新模型出发:先做出更大的生成器或预测器,再寻找可以使用它的任务。科学问题牵引则先定位研发流程中最昂贵、最慢或最容易出错的决定,再判断 AI 是否适合改善这个决定。
两种路径都可能产生研究价值,但资源分配方式不同。生成大量分子很适合展示模型能力;如果项目真正卡在靶点选择、实验不可比或临床入组上,继续扩大分子生成量不会解决瓶颈。
团队应该直接回答:“模型改变了哪一个决定,以及这个决定为什么值得改变?”
从模型结果到患者获益需要哪些证据

这是概念性流程图。图中卡片宽度和候选数量不代表行业统计比例,具体研发路径也会因药物类型与适应症而不同。
计算结果首先是待验证假设。候选能否合成、实验能否重复、生物学机制是否成立、毒性是否可接受、人体内是否产生治疗获益,都需要后续证据。每个阶段都可能推翻上一阶段看起来很有希望的结果。
AI 可以帮助选择下一项实验、预测失败风险或整理多源数据,但模型置信度不能作为临床疗效证据。
临床影响证据有限,不等于已经证明无效
2026 年的 Nature Reviews 文章认为,AI 药物研发已有大量方法、应用和 benchmark,但临床相关影响的证据仍然有限。这句话不能反过来解释成“AI 制药已经失败”。
较成熟的新方法出现的时间,可能还短于一款药从发现走到完整临床验证所需的周期。许多项目仍在研发途中,结果尚未成熟。现在既不能用早期跑分提前宣布行业革命,也不能因为上市药物不多就认定这些方法没有价值。
合理的做法是持续追踪中间决策是否改善,并等待足够长的临床结果。
怎样做更接近现实的验证
团队可以把模型验证分成几层:
- 时间外推:用训练截止时间之后产生的数据测试;
- 外部验证:换实验室、项目、设备或患者来源;
- 前瞻验证:在结果尚未知时让模型参与真实决策;
- 湿实验验证:用合成、细胞或动物实验检查预测;
- 决策验证:记录模型是否改变候选淘汰、实验选择和资源投入;
- 临床验证:跟踪人体安全性、疗效和最终患者获益。
不同层级回答的问题不同。静态测试集适合筛查模型错误,外部和前瞻研究才能逐步说明它是否适合真实流程,临床试验则负责回答对患者是否有效。
AI 制药的近期价值可能没那么戏剧化
Hacker News 讨论中,一些从业者把 AI 的日常价值描述为安装和使用专业工具、编写分析脚本、检查实验方案、整理数据,或更快得到一个可供实验的起始结构。这些是社区个人经验,不代表行业统计。
这种价值仍然重要。研究人员每天少花一些时间处理软件和数据,可以把更多精力放在实验设计和结果解释上。它不会立刻产生一款新药,也很难进入“AI 发现药物”的宣传标题,但可能是技术真正进入研发流程的第一步。
AI 制药是否成功,最后要看它能否让关键决策更准确,让实验更少浪费,并帮助更安全、更有效的药物更快到达患者。模型排行榜只覆盖早期计算环节。
收看本期节目
原始资料与延伸阅读
本文由《听懂 AI》第 007 期整理而成。节目主要来源是 Andreas Bender、Morgan C. Thomas、Jack W. Scannell 等作者于 2026 年 8 月 7 日发表在 Nature Reviews Drug Discovery 的观点文章《Artificial intelligence in drug discovery — what it is, where we stand and the path forward》。本文补充 FDA 的药物研发流程资料和 AlphaFold 原始论文。Hacker News 讨论只作为社区观察,不作为临床效果证据。
- Andreas Bender、Morgan C. Thomas、Jack W. Scannell 等,2026-08-07:Artificial intelligence in drug discovery — what it is, where we stand and the path forward——Nature Reviews Drug Discovery 观点文章,主张把评测重点从模型验证转向研发决策和临床转化。
- U.S. FDA:Step 1: Discovery and Development——候选发现之后需要评估的药代、剂量、毒性和人群差异。
- U.S. FDA:Step 3: Clinical Research——人体临床研究的目的、阶段和证据要求。
- John Jumper 等,2021-07-15:Highly accurate protein structure prediction with AlphaFold——AlphaFold 在蛋白结构预测上的原始研究,不能单独代表完整药物研发周期。
- Derek Lowe:So How is AI Drug Discovery Doing, Really?——Hacker News 条目实际提交的 Science 评论文章,属于对 Nature Reviews 观点文章的二次讨论。
- Hacker News:AI in drug discovery — what it is, where we stand and the path forward——上述 Science 评论的社区讨论;评论只代表参与者观察。
资料说明:本文讨论研发评测与证据边界,不提供药物、疾病或临床决策建议。Nature Reviews 原文是一篇多作者观点文章,不是单项 AI 模型的临床试验;文中的流程图和评测建议是编辑阶段的概念性整理。

TL;DR:模型能力越强,授权给它的风险和不确定性也被放大——更强的模型意味着更难预测的行为、更高的单次成本和更深的信任依赖。一问一答讨论为什么“换更强的模型”不总是安全答案。
模型跑分提高,和它更适合一起工作,并不是同一件事。
一个编码 Agent 可以更快定位错误、完成更长的任务,也可能在需求有歧义时替人选定方向。它交付得更快了,人却不敢离开屏幕:每隔几分钟就要检查它是否扩大范围、改变计划,或把某个未写出的假设当成事实。
🎬 视频版(B站) | 🎧 音频版(4 分 05 秒)| 🟢 Spotify 订阅 | 📖 偏好阅读?文字版就在下方 👇
原文到底在抱怨什么
Mun Logadan 并没有说 Opus 5 能力倒退。相反,他认为它比 Opus 4.7、4.8 更有能力,benchmark 表现也很强。让他不舒服的是协作方式:
- 意图不清楚时,不太愿意停下来询问;
- 信息缺失时,会自行补充假设;
- 已有计划存在多种解释时,可能不经确认就重新理解或修改。
这会产生一种反直觉的体验:模型更能完成任务,人却需要更仔细地看守它。这里的证据只是个人观察。它能说明一种真实存在的使用问题,不能证明所有用户都会遇到,也不能据此给 Opus 5 的整体能力下结论。
官方叙事和个人体验为什么会冲突
Anthropic 在 2026 年 7 月 24 日发布 Opus 5 时,把它描述为更主动、更适合长时间多步骤工作的模型。官方公布了 Frontier-Bench、CursorBench、OSWorld 等结果,并列出大量早期客户反馈,其中一些特别称赞它会验证工作、发现隐患,或只在需要人类判断时把人拉回来。
这些材料证明了 Anthropic 想优化的方向,也提供了具体使用案例,但仍主要来自厂商评测和早期客户引述,并不是独立的用户体验研究。个人文章关注的又是另一种场景:任务文本没有写全,隐性业务约束很多,选错方向的代价高。
同一种“主动性”,在两类任务里可能得到相反评价:
- 任务自包含、结果可自动检查时,主动补步骤能节省时间;
- 任务依赖未写出的组织背景时,主动补假设可能扩大风险。
所以争议不一定是谁对谁错。双方测量的对象不同:一个更接近“模型能否完成”,另一个更接近“人是否放心让它完成”。
隐藏上下文才是现实工作的难点
“重构登录模块”看起来是一句完整需求,实际可能牵涉旧客户端兼容、审计要求、埋点协议、上线窗口和客户承诺。这些信息可能散落在代码、文档、工单和人的记忆里,不会自动进入提示词。
模型可以写出结构漂亮、测试全绿的新实现,却仍然删掉某个不能改变的旧行为。问题不一定是它不会写代码,而是它不知道自己缺少了哪些背景。
现实任务还经常没有唯一正确答案。两个方案都能运行,但预算、团队经验、发布节奏或维护责任会改变选择。Agent 如果继续执行,就相当于替项目负责人做了技术之外的取舍。
benchmark 的解释为什么只能当作线索
原文猜测,强调 benchmark 的训练环境可能鼓励模型在歧义面前大胆选择答案,因为一项设计良好的评测通常会提供足够信息,并保证存在可以评分的结果。模型如果反问任务设计者,反而无法得分。
这个解释有启发,但没有证据证明 Opus 5 的具体协作行为由某种 benchmark 或训练方式造成。官方发布材料也没有提供能支持这条因果链的数据。
现有证据只能说明,单独测任务成功率可能遗漏“何时需要人类输入”这项能力。真实工作既要看模型能不能解题,也要看它能否发现题面之外的关键决定。
多问问题也不是答案
让 Agent 每做一步都询问,同样会让自动化失去意义。更实用的做法是同时判断三个因素:
- 歧义:目标是否有多种合理解释;
- 后果:选错会影响多少用户、数据或外部系统;
- 可恢复性:操作能否低成本撤回和验证。

这是文章中的编辑性框架,不是对 Opus 5 或其他模型的实验结果。
边界清楚、风险低、容易撤回的操作,可以直接完成并留下记录。信息不全但后果较轻时,可以声明假设,只做一个可回退的小步骤。动作虽然明确,但涉及发布、删除、付款或数据迁移时,应先取得审批。歧义和后果都很高时,Agent 应停止并请人决定方向。
问题是否有价值,要看它能不能改变方案或风险,而不是看数量。
注意力也应该计入生产力
Hacker News 讨论后来扩展到模型的固定写作句式、冗长注释和无关改动。有人认为这些问题严重消耗注意力,也有人觉得影响有限。这些都属于社区观察,不是统一实验结果。
但它们提醒了一个容易漏掉的成本:任务完成之后,人还要花多久才能信任结果。一个模型单次成功率更高,如果每次都要清理无关修改、核对隐藏假设和恢复越界操作,整体生产力未必同步提高。
团队可以记录这些指标:
- 人工持续盯守的时间;
- 审查和返工耗时;
- 偏离计划的次数;
- 越权或不可逆操作的次数;
- 出错后恢复到安全状态所需的时间;
- 因为信任不足而无法开放的工具和权限。
能力决定 Agent 能做多复杂的任务,协作成本决定团队愿意给它多大的行动范围。
怎样设计更合适的审批点
团队不必把所有背景写成一份无限增长的规则文件。固定约束适合写进项目说明,动态取舍则需要运行时判断:
- 明确只读目录、允许的工具和必须审批的外部写入;
- 要求 Agent 在高风险任务开始前复述目标、假设和不可改变的约束;
- 把大任务拆成可检查、可撤回的阶段,每阶段提供真实读回证据;
- 偏离已批准计划前,说明原因和影响并重新请求授权;
- 对发布、删除、迁移、付款和凭据操作设置明确审批点;
- 记录人类介入的位置,持续调整哪些步骤可以自动化。
规则文件能保护已经知道的边界,审批机制负责处理还没写进规则的新情况。两者缺一不可。
评测“知道何时问”可以怎么做
如果只给模型材料齐全、答案明确的任务,就很难观察它怎样处理现实中的不完整信息。更贴近协作的 Eval 可以故意留下关键歧义:
- 提供两个都能运行、但业务含义不同的方案;
- 隐去一个会改变设计的权限或兼容约束;
- 混合可撤回操作与不可逆操作;
- 在执行中途加入与原计划冲突的新证据。
评价时不应只数模型问了多少问题,还要看它是否发现真正会改变结果的歧义,是否区分可逆与不可逆操作,是否在偏离计划前请求授权,以及人类总共花了多少时间介入。
这套指标仍是一种编辑性建议,不是现成的行业标准。它至少把“感觉更累”转换成了可以记录和比较的协作成本。
收看本期节目
原始资料与延伸阅读
本文由《听懂 AI》第 006 期整理而成。节目主要讨论 Mun Logadan 于 2026 年 8 月 14 日发布的个人文章《Why does Opus 5 feel worse to work with?》,并补充 Anthropic 的 Opus 5 发布说明和 Hacker News 社区讨论。原文描述的是作者及同事的使用感受,不是模型对照实验;关于训练和 benchmark 的解释也被作者明确标为推测。
- Mun Logadan,2026-08-14:Why does Opus 5 feel worse to work with?——个人及同事的协作体验;关于训练与 benchmark 的解释由作者标为推测。
- Anthropic,2026-07-24:Introducing Claude Opus 5——官方发布说明、厂商评测和早期客户案例,不应视为独立用户研究。
- Hacker News:Why does Opus 5 feel worse to work with?——社区对自主性、写作风格、注释和审核成本的讨论;评论只代表参与者观察。
资料说明:本文没有证明 Opus 5 比旧模型更难协作,也没有把作者的训练猜测当作事实。关于审批矩阵、协作成本和 Eval 的部分,是基于原文问题做出的编辑性整理与实践建议。

比较 AI Agent 时,人们往往先问“用了哪个模型”。但模型只是其中一部分。它能访问哪些文件和工具、怎样管理上下文、何时请求批准、如何恢复失败、把运行记录保存在哪里,这些都由模型之外的 Harness 决定。
DeepSeek Harness 的 Developer Preview 把这层基础设施单独摆到台面上,并给出两个醒目的设计目标:所有能力都可以作为插件替换;每次运行都能从同一条事件流中追溯。
本文由《听懂 AI》第 005 期整理而成。主要来源是 DeepSeek Harness 官方站点、GitHub 仓库和架构文档。2026 年 8 月 26 日发布的 Cordis 预印本补充了可逆副作用和动态依赖的理论说明。项目截至 2026 年 8 月 28 日仍处于 Developer Preview,官方明确表示会出现破坏兼容性的变更。
🎬 视频版(B站) | 🎧 音频版(5 分 04 秒)| 🟢 Spotify 订阅 | 📖 偏好阅读?文字版就在下方 👇
Harness 到底负责什么
模型可以生成文本或工具调用意图,但它不能直接在操作系统里“自己做事”。Harness 负责把模型接进真实环境:
- 组装系统提示、历史消息和工具描述;
- 暴露文件、终端、搜索、网络等能力;
- 执行工具并把结果送回模型;
- 管理循环、子智能体、上下文压缩和停止条件;
- 应用权限、审批、沙箱和凭据策略;
- 保存会话、运行状态、错误和遥测信息。
同一个模型放进不同 Harness,能完成的任务、消耗的 token、失败方式和安全边界都可能不同。因此,评估 Agent 不能只看模型跑分,还要看它周围这套运行系统。
“所有东西都是插件”具体指什么
DeepSeek Harness 建在 Cordis 插件系统上。官方架构文档没有保留一个不可替换的特权核心:模型适配器、工具注册表、会话日志、智能体循环、沙箱、存储、调度和网页界面都通过插件提供。
这些插件把服务、带类型的事件和依赖关系挂到共享上下文中。开发者可以在配置里替换某个提供者,而不是修改 Harness 源码。例如,换掉模型适配器、把本地文件系统改成远程沙箱,或给某类会话使用不同的工具组合。
运行时并不是简单扫描一个插件目录。它按照 Profile、Bundle、用户补丁和命令行覆盖层组成一棵有顺序的插件树。官方提供 dsh --profile web --dump-config,让开发者查看机器最终实际启动的配置,而不是只看散落在多层文件中的声明。
可逆副作用能解决什么
插件卸载不只是删除一段代码。它可能已经注册监听器、打开连接、挂载服务或启动后台任务。Cordis 要求可撤销的注册在创建时同时登记清理函数,插件卸载时再按生命周期收回这些效果。
2026 年 8 月 26 日提交的 Cordis 论文把这种机制称为“时间可组合性”:组件产生的上下文变化带有逆操作,运行时负责保存并执行。论文还讨论“空间可组合性”,即组件根据声明的依赖动态激活和停用。
这个机制能清理框架知道并登记过的副作用,却不能倒转所有现实操作。插件如果已经删除外部文件、调用第三方 API 或泄露凭据,卸载函数无法让这些事情自动消失。生命周期清晰不等于风险消失。
“每次运行都可追溯”不是读心术
DeepSeek Harness 把会话视为只追加的 SessionEvent 事件流。用户输入、模型请求、模型返回、工具调用与结果、步骤开始结束等事实写入同一记录。下一轮模型历史由日志重新投影,恢复、分叉、搜索、重放、遥测和持久化也从这条事件流派生。
官方文档提出一条运行时约束:“模型可见”就必须能够从日志重建。也就是说,任何真正送进模型请求的内容都应留下对应事件,避免界面显示一套历史、模型实际收到另一套历史。

图中只展示架构关系。实际插件、事件和运行模式以当前配置及官方文档为准。
可追溯不等于能够读取供应商隐藏的内部推理。Harness 只能记录自己收到、创建或发送的内容;如果模型 API 没有返回完整 Chain of Thought,它不会凭空出现在会话日志里。日志透明的是执行链,而不是模型供应商没有暴露的内部状态。
四种模式对应不同的实验目标
官方当前提供四种运行模式:
- Standard:完整编码 Agent,包括文件、终端、搜索、技能、计划、目标和子智能体;
- Code:模型可以通过 Code Mode SDK 在一个 TypeScript 程序中组合多轮工具操作;
- Minimal:只保留持久 Bash 和文件编辑器,用于较小、容易比较的模型评测环境;
- Creator:在 Standard 能力上增加运行时检查、内存插件试验和 Profile 编写指导。
这些模式的意义不只是功能多少。Minimal 可以减少 Harness 自身对评测结果的干扰;Creator 则把插件开发和组合变成产品能力。团队也可以由基础 Bundle 开始,只为特定项目增加必要插件。
插件化和事件流带来的价值
对于研究者和 Agent 基础设施开发者,这种架构便于回答过去很难分开的实验问题:
- 同一个模型换不同工具集,结果差多少;
- 本地沙箱和远程沙箱怎样影响安全与性能;
- 换掉上下文压缩策略后,恢复和长会话表现是否变化;
- 某次失败究竟来自模型、工具、权限、上下文还是循环控制;
- 会话能否从相同事件边界稳定恢复或分叉。
插件边界让替换实验更容易,事件流则提供统一的观察依据。它们提供的是实验和组合能力,不是“换插件一定更好”的保证。
当前最重要的标签仍是 Developer Preview
截至 2026 年 8 月 28 日,官方仓库仍明确写着 Developer Preview,并警告会有破坏兼容性的变更。安全说明更加直接:项目尚未经过安全审计,不能视为安全或生产就绪的软件。
DeepSeek Harness 可以执行模型生成的代码和命令,加载第三方插件,并访问用户允许的网络、进程、凭据和文件。错误模型输出、缺陷、配置错误、恶意输入或不可信插件都可能修改或删除文件、泄露数据,甚至损害宿主机。
官方还强调,沙箱、审批和权限控制只能降低风险,不能保证完全隔离;系统无法保护已经被明确授权访问的资源。社区关于“插件疲劳”、版本冲突和供应链攻击面的担忧因此是合理的工程问题,但 HN 评论只是社区观察,不代表项目已经出现了这些事故。
现在怎样安全地试
如果只是想比较模型或研究 Harness,可以从隔离实验开始:
- 使用一次性虚拟机、容器或专用环境;
- 只挂载测试项目,不开放主目录和真实仓库;
- 不注入生产凭据、SSH Key 或云端密钥;
- 采用最小权限和人工审批,先从 Minimal 模式或较小插件集开始;
- 阅读第三方插件源码、依赖和配置,再允许执行;
- 给可访问文件做备份,并记录外部 API 的副作用;
- 保存
--dump-config结果和版本信息,方便重现实验; - 接受接口可能变化,不把当前 Profile 当成长期稳定契约。
DeepSeek Harness 把模型之外的运行系统摆到了开发者面前,让工具、会话、沙箱、循环和存储都可以观察和替换。它能否从实验台走向稳定生态,取决于接口治理、安全审计、插件质量和长期兼容性。
收看本期节目
原始资料与延伸阅读
- DeepSeek:DeepSeek Harness Developer Preview——产品定位、运行模式和当前 Preview 状态。
- DeepSeek AI:deepseek-harness GitHub 仓库——源码、安装、许可证与兼容性警告。
- DeepSeek Harness Docs:Architecture Reference——插件树、事件流、Profile、Bundle 和运行时约束。
- DeepSeek AI:Safety Notice——安全审计状态、沙箱限制与负责任使用要求。
- Yifan Shi、Wei Zhang、Tianyi Cui 等,2026-08-26:A Programming Paradigm for Spatiotemporal Composability——Cordis 可逆效果与动态依赖的理论说明,当前为 v1 预印本。
- Hacker News:DeepSeek Harness developer preview——社区对插件治理、兼容性和供应链风险的讨论;评论不代表已验证事实。
资料说明:本文描述的是 2026 年 8 月 28 日可见的 Developer Preview。仓库和 API 正在快速变化,后续版本可能调整名称、模式、接口和安全边界。

TL;DR:AI 编程工具压缩的是“写出代码”的时间,但理解设计、审查影响、验证行为和长期维护并没有同步变快——Florian Herrengt 在 2026 年 8 月 11 日的文章中,把这层被挤压的空间称为软件工程的“中间地带”。本文结合 GitHub、METR 与 DORA 的研究核对一个关键问题:写得更快,是否真的等于生产力更高。
AI 编程工具最直观的变化,是让“写出一批能运行的代码”变得更快。一个需求可以在几小时内长出页面、接口、数据表和测试,过去需要几天的实现工作被压缩到一个下午。
但软件交付并不在代码生成时结束。团队还要理解设计、审查影响、验证行为、迁移数据、处理故障,并在几个月后继续修改。生成速度提高后,这些工作反而更容易成为新的瓶颈。
🎬 视频版(B站) | 🎧 音频版(5 分 09 秒)| 🟢 Spotify 订阅 | 📖 偏好阅读?文字版就在下方 👇
原文所说的“中间地带”是什么
Herrengt 描述了一个常见场景:周一早上出现多个由 Agent 生成的巨大合并请求,功能看起来能运行,却没有人能清楚解释数据从哪里来、为什么增加某个抽象、失败后如何恢复。设计依据甚至只存在于一条来回改口的模型对话里。
他所谓的“工程师中间层消失”,不是一项职业分类研究,而是一个比喻:当实现和集成越来越容易,单纯把规格翻译成代码的价值可能下降;能够理解复杂系统、判断取舍并对结果负责的人会更重要。
原文中的“25,000 行合并请求”“一下午生成 20,000 行”等数字是叙事例子,不是行业平均值。文章对薪资分化和岗位减少的判断也是作者预测,不能当成已经发生的统计结论。
AI 到底让开发者快了多少
不同研究给出的答案并不一致,因为它们测量的任务完全不同。
GitHub 在一项受控实验中让 95 名专业开发者完成同一个 JavaScript HTTP 服务器任务。使用 GitHub Copilot 的一组平均用时 1 小时 11 分,未使用的一组平均用时 2 小时 41 分,前者快 55%。这是一个范围清楚、自动测试可以判断完成度的单项任务。
METR 在 2025 年研究了另一种情境:16 名熟悉大型开源项目的开发者完成自己仓库里的 246 个真实任务。允许使用当时的 AI 工具后,任务完成时间反而增加了 19%。参与者原本预计会快 24%,做完后仍主观认为自己快了 20%。
这项结果也不能推广到所有开发。它只代表 2025 年初的工具、这些开发者和成熟仓库。METR 在 2026 年公布的后续数据出现了可能的加速信号:原研究参与者子集估计快 18%,新招募开发者估计快 4%,但置信区间都包含没有提升的可能,而且不愿离开 AI 工具的开发者更容易退出实验,造成明显的选择偏差。研究团队因此决定调整实验设计。
三组结果放在一起,能得到一个更可靠的判断:AI 对明确、局部、容易验证的实现任务可能明显提速;在熟悉但复杂的长期项目中,上下文、验证和协作成本可能抵消一部分收益。不能用一个百分比概括全部软件工程。
瓶颈从敲代码移到理解变化
实现变快以后,团队要处理的变更数量和批次都可能增加。每个变更仍需要回答这些问题:
- 它是否符合真实业务约束;
- 新抽象是不是必要;
- 数据迁移失败时怎样回滚;
- 测试是否覆盖了没人想到的行为;
- 出现线上事故时,谁能解释和修复;
- 半年后还有没有人知道为什么这样设计。

图中流程是一般性的交付模型,不代表每个团队都使用相同阶段,也没有给出行业统一的速度比例。
DORA 的 2025 年研究把 AI 描述为组织能力的“放大器”:基础流程、平台和文化较强的团队更容易获得收益,原有弱点也可能被同步放大。DORA 在 2026 年的后续分析中还指出,生成阶段节省的时间经常转移到审计和验证;更高的 AI 使用与更高吞吐量、同时也与更高交付不稳定性相关。这里是关联关系,不等于 AI 单独造成了不稳定。
代码行数和 PR 数量为什么会骗人
一个人一天提交十个 PR,看起来像生产力提高了十倍。如果三个审查者接下来花两天理解、退回和重写,工作只是从生成者转移到了团队其他成员。
代码行数、PR 数量和“完成”的任务卡都属于局部产出指标。团队真正关心的是从需求到安全上线的完整周期,以及上线后的失败率、恢复时间、维护成本和知识是否有人掌握。
这并不意味着大改动永远错误,也不意味着技术债绝对不能欠。团队必须知道自己接受了什么风险、为什么此刻值得接受,以及准备怎样偿还。
“工程师两极分化”仍然只是预测
原文认为,AI 会扩大优秀工程师和较弱工程师之间的薪资差距。这是作者的判断,不是文章提供数据证明的结论。
现有证据只足以说明,AI 正在改变工程技能的相对价格。模板实现、样板代码和常规转换越来越便宜;需求澄清、系统建模、复杂度控制、测试设计、事故处理和技术取舍仍然需要大量上下文与责任承担。
初级工程师也不等于“只能写 CRUD”。原文自己举了相反例子:愿意追问、建立理解并检查假设的初级开发者,可能比已经放弃理解的资深开发者更可靠。风险不在职级,而在于是否把 AI 当作建立理解的工具,还是替代理解的借口。
怎样避免代码增长快过团队理解
团队可以从变更规模和知识所有权入手:
- 要求 Agent 把任务拆成可独立审查的小改动;
- 合并请求必须说明设计理由、替代方案和主要风险;
- 用测试和 Eval 验证行为,不只验证代码能编译;
- 数据库、权限和基础设施变更必须写回滚方案;
- 生成代码的人要能不用聊天记录解释数据流和故障模式;
- 同时衡量审查负荷、交付周期、变更失败率和恢复时间;
- 把模型对话中的关键决定整理成团队可维护的文档。
使用 AI 并不等于放弃工程判断。真正需要警惕的是,代码已经进入生产,而团队仍不知道它为什么存在、会影响谁,以及出错后该怎么办。
收看本期节目
原始资料与延伸阅读
本文由《听懂 AI》第 004 期整理而成。节目来源是 Florian Herrengt 于 2026 年 8 月 11 日发布的个人文章《AI is removing the middle class of software engineering》。原文以作者经历和判断为主,并不是就业市场或软件质量的统计研究;本文另外引入 GitHub、METR 和 DORA 的研究,核对“写得更快是否等于生产力更高”。
- Florian Herrengt,2026-08-11:AI is removing the middle class of software engineering——个人经验与观点文章。
- GitHub Research:Quantifying GitHub Copilot’s impact on developer productivity and happiness——95 名开发者完成固定 JavaScript 任务的受控实验。
- METR,2025-07-10:Measuring the Impact of Early-2025 AI on Experienced Open-Source Developer Productivity——16 名成熟开源项目开发者、246 个真实任务的随机实验。
- METR,2026-02-24:We are Changing our Developer Productivity Experiment Design——晚 2025 工具的后续信号、选择偏差和实验设计限制。
- DORA,2025:State of AI-assisted Software Development——AI 使用与组织系统、吞吐量和稳定性的研究框架。
资料说明:原文关于“中间层”、薪资和就业结构的描述属于作者观点。本文补充的研究测量了不同任务和组织情境,结果不可直接互相替代,也不能用于预测单个岗位的未来。

TL;DR:2026 年 8 月 10 日提交的论文《Stealing Reasoning Traces from Proprietary LLM APIs》指出:大模型 API 返回的加密推理块可能被跨会话复用,研究者把它交给同厂商防护较弱的兼容模型处理,即可还原隐藏推理。论文归纳了四类风险,但测试限于 2026 年 7 月初的特定 API 与模型版本,结论不能直接外推到今天所有接口。
看到一段无法阅读的加密文本,人很容易把它当成“安全的乱码”。但在大模型 API 里,这类不透明数据可能保存着模型的隐藏推理、工具返回值,甚至用户输入过的敏感信息。
2026 年 8 月提交的论文《Stealing Reasoning Traces from Proprietary LLM APIs》提出了一个反直觉的风险:研究者没有暴力破解密钥,也没有直接攻破防护最严的前沿模型,而是利用加密推理块可以跨会话、跨用户和跨模型复用的特性,把它交给同一家服务商中防护较弱的兼容模型处理。
🎬 视频版(B站) | 🎧 音频版(4 分 02 秒)| 🟢 Spotify 订阅 | 📖 偏好阅读?文字版就在下方 👇
什么是“加密推理块”
推理模型在给出最终回答前,会生成较长的中间推理。服务商通常不把完整推理以明文返回,而是向客户端提供摘要,以及一段签名或加密后的不透明数据。客户端保存这段数据,并在下一轮请求时原样传回,让模型延续之前的推理状态。
论文把这种数据描述为经过认证加密的封装。它既能防止用户直接阅读,也能检测内容是否被篡改,同时让服务端不必长期保存每次会话的完整推理。
需要注意,论文作者也明确说,各服务商没有公开完整的密码学实现。因此,文章中的具体结构和密钥使用方式来自研究者的实验观察与推断,不是服务商公开的协议承诺。
问题不一定是“加密被破解”
论文发现的关键在于兼容范围过大。一个推理块可能被拿到另一段会话、另一个用户,甚至同一服务商的另一个模型中继续使用。
攻击者可以先从能力强、拒绝训练更严格的模型获得一个加密推理块,再把它送给较弱但兼容的模型。后者本来就需要合法解开并处理这类数据,研究者再诱导它把处理到的内容输出出来。
整个过程不需要知道加密密钥,也没有修改密文。真正失守的是“这段加密数据只能在原来的用户、会话和模型里使用”这一安全边界。

示意图只说明安全边界和防御方向,不包含论文中的具体攻击提示或供应商实现细节。
论文描述了四类风险
第一类是模型蒸馏。竞争者可能批量提取强模型的隐藏推理,用来训练或模仿另一个模型,绕过服务商隐藏思维过程的初衷。
第二类是敏感数据泄露。开发者公开 Agent 会话、评测轨迹或 API 日志时,常常只清理肉眼可见的文本,却保留看似无害的不透明推理块。秘密可能仍藏在里面。
第三类是拒答背后的危险内容。模型最终可能正确拒绝一个恶意请求,但隐藏推理已经处理过更具体的信息。如果推理块可以被恢复,安全的最终回答并不代表整个执行过程都没有泄露。
第四类是不可见提示注入。恶意指令可以隐藏在不透明数据中,人工审查日志时看不见,后续接手同一轨迹的 Agent 却可能读取并执行。论文把它作为概念验证和长时任务污染风险来讨论。
31 万个推理块里发现了什么
研究者从 GitHub 和 Hugging Face 收集了 6,708 条公开 Agent 轨迹,重建了 315,320 个推理块。完整论文给出的统计包括:
- 1,028 个推理块,也就是约 0.3%,包含至少一项隐私泄露;
- 328 条轨迹,也就是 6,708 条中的 4.9%,至少泄露过一项真实敏感信息;
- 在排除基准测试身份后的真实用户会话中,研究者去重得到 704 项隐私数据;
- 其中包括 62 个 API Key、33 个密码、24 个访问令牌、7 个私钥和 30 个个人邮箱;
- 64 项数据只出现在隐藏推理中,没有出现在可见聊天记录里。
论文摘要还用另一组分类口径概括为 367 项个人身份信息和 182 项凭据。不同数字对应不同分类、去重和数据范围,不能直接相加,也不能理解成同样数量的独立受害者。
研究样本来自公开轨迹,不是对整个互联网或所有生产系统的普查。论文也使用两阶段自动分类筛掉占位符和测试数据,但这仍是一项定向研究,不是完整的泄露率调查。
为什么“我已经清理日志”仍可能不够
论文给出的一个典型风险是会话清理:用户要求 Agent 删除仓库中的秘密,模型在隐藏推理中重新读取并复述这些值;最终可见回答只说“已经清理”,但不透明推理块仍可能保留原值。
因此,只搜索最终回答里的 API_KEY 或密码格式并不够。共享原始 API 记录前,还需要删除 signature、thinkingSignature、encrypted_content 等不透明推理字段。字段名称会随供应商和 SDK 改变,不能依赖一份永远不变的黑名单。
如果含有此类数据的会话已经进入公开 Git 仓库,删除最新文件也不代表历史提交消失。应当检查 Git 历史、缓存、制品和数据集副本,并轮换可能已经暴露的凭据。
论文有哪些限制,漏洞现在还存在吗
这篇论文是 2026 年 8 月 10 日提交的 v1 预印本。实验针对 2026 年 7 月初的 Anthropic、OpenAI 和 Google API 版本,服务商可以在不公告的情况下改变内部实现。
作者无法看到隐藏推理的真实明文,因此不能逐字证明每次提取都完全正确。他们主要用 API 报告的思考 token 数量与恢复文本的 token 数量做对照,并在 120 个 Codeforces 问题上观察到较强的一致性。这是提取可信度的证据,但不是完整的明文真值验证。
论文还说明,团队在发表前已向相关模型服务商、Microsoft 和 Hugging Face 负责任披露。作者报告说,各服务商确认收到报告,此后他们已经无法用相同方法继续发动攻击。这说明供应商可能采取了缓解措施,但不能据此推断所有历史数据已经安全,也不能证明所有相邻攻击面永久消失。
服务商和开发者分别能做什么
论文建议服务商使用多层防御:
- 把完整推理留在服务端,客户端只拿随机句柄;
- 在认证加密中绑定用户、会话、模型、前序提示和对话历史;
- 在 API 网关阻止跨模型推理块;
- 为异常重放提供签名或密钥撤销机制;
- 训练模型拒绝输出隐藏推理,并监控异常提取模式。
更严格的上下文绑定会影响合法的会话压缩、历史编辑和模型切换,因此不是简单增加一个字段就能完成。即使绑定正确,只要某个模型必须解开并处理旧推理,模型级提示攻击仍可能成为风险,所以需要纵深防御。
开发者现在可以做这些事:
- 把不透明推理块当作敏感数据,而不是普通日志;
- 发布会话、轨迹或复现包前,删除完整推理字段;
- 不把未经验证的外部推理块传给 Agent;
- 检查已经公开的仓库与历史提交,必要时轮换凭据;
- 在日志策略里明确区分可见回答、工具结果和隐藏推理载荷。
密文不是废数据,也不是天然安全的秘密存储。看不懂一段内容,只说明人无法直接阅读,并不代表系统中的其他组件也无法处理它。
收看本期节目
原始资料与延伸阅读
本文由《听懂 AI》第 003 期整理而成。事实来源是 Alexander Panfilov 等 8 位作者于 2026 年 8 月 10 日提交的 arXiv 预印本及作者项目页。论文测试的是 2026 年 7 月初可用的特定 API 和模型版本,不能直接代表今天所有接口仍然存在相同行为。
- Alexander Panfilov、David Schmotz、Ilia Shumailov 等,2026-08-10:Stealing Reasoning Traces from Proprietary LLM APIs
- arXiv:论文 HTML 全文——包含威胁模型、实验结果、限制、披露过程和缓解方案。
- 论文作者:Stolen Thoughts 项目页——论文结果的交互式说明;示例中可能包含安全研究材料,阅读时不要复制其中的攻击提示或凭据样例。
资料说明:本文的技术结论和数字均来自论文 v1。论文作者报告的攻击状态、供应商范围和缓解结果具有时间性,后续版本或服务商更新可能改变结论。

TL;DR:NVIDIA 于 2026 年 8 月 11 日发布的 Nemotron 3.5 Lightning 与 NeMo Switchyard,瞄准的是 AI Agent 的模型路由问题:让规划等复杂步骤用强模型,工具调用、格式整理等步骤交给更小更便宜的模型。本文同时核对了评测边界、降本数字的前提,以及仓库仍标注 pre-alpha 的现实——它值得跟踪,但还不是能直接上生产的组件。
一个 AI Agent 真正运行起来以后,并不是每一步都需要最强模型。制定计划、处理复杂异常,可能值得调用能力最强的模型;执行工具、检查返回值、整理格式和重复查询,往往更在意速度和成本。
如果所有步骤都交给同一个昂贵模型,效果容易预测,账单和延迟却会迅速增加。反过来,如果只用便宜模型,复杂任务又可能失败。模型路由想解决的,就是如何在这两种选择之间分工。
🎬 视频版(B站) | 🎧 音频版(5 分 53 秒)| 🟢 Spotify 订阅 | 📖 偏好阅读?文字版就在下方 👇
Agent 不只需要一个模型
传统聊天产品通常把一次请求交给一个固定模型。Agent 的情况不同:它可能先规划,再调用工具,读取结果,修正计划,最后生成答案。一次任务里会出现很多性质不同的步骤。
NVIDIA 把这种架构称为“模型系统”:前沿推理模型负责规划和编排,小而快的模型承担代码检查、工具调用、安全告警监控和账单查询等高频工作。这个思路并不要求小模型取代大模型,而是让每种模型做自己更合适的事。
Nemotron 3.5 Lightning 小在哪里
Nemotron 3.5 Lightning 是一个 300 亿参数的混合专家模型(MoE),但每个 token 只激活约 30 亿参数。可以把它理解成一个拥有多个专家小组的组织:总知识容量仍然较大,每次任务只叫少数专家参与,因此单次计算量接近更小的稠密模型。
NVIDIA 的技术文章称,它针对长期运行 Agent 的高频执行层设计,并使用多 token 预测、推测解码和量化等手段提高吞吐量。官方公布的结果包括:
- 相比同级模型,输出速度最高可达 4 倍;
- 在 PinchBench 上达到 86% 准确率,完成 1 万个任务的时间比 Qwen3.6 35B 快 30%,同时保持接近的准确率;
- 提供 BF16 和 NVFP4 检查点,可用于本地和数据中心部署。
这些都是 NVIDIA 选择的测试条件和对照模型,适合用来理解产品定位,不能直接换算成任何业务的固定收益。真实效果仍取决于任务分布、推理框架、硬件、并发量和输出长度。
Switchyard 不只是一个“选模型”按钮
NeMo Switchyard 是一个用 Rust 编写的代理和路由库。它能在不同模型与供应商之间分配请求,也负责 OpenAI Chat、OpenAI Responses 和 Anthropic Messages 等接口格式之间的转换。
仓库目前提供多种路由方式:
- 用一个分类模型判断请求应该进入强模型还是弱模型;
- 根据工具结果、错误等会话信号分阶段路由;
- 先让弱模型回答,再由评审决定是否升级;
- 按固定比例随机分流,用于 A/B 测试;
- 编写自定义算法,把质量、延迟和成本偏好放进自己的规则。

这张图表示一般性的模型路由结构,不代表 Switchyard 会自动识别所有任务,也不表示三类模型一定同时存在。
路由器本身也会消耗资源。真实总成本不仅包括最终模型调用,还包括路由判断、额外分类模型、缓存补齐、失败重试和升级调用。若没有统一的质量门禁,所谓“节省成本”可能只是把错误推迟到后面。
那些漂亮的降本数字该怎么看
NVIDIA 公布的内部基准称,Switchyard 在保持前沿级准确率的同时,可把任务完成成本降到单独使用 Opus 4.8 的近三分之一。合作方数据中还有两组很醒目:
- LangChain 在 145 个多轮 Deep Agents 任务中,只把 7% 的调用交给前沿模型,成本降低 74%,但准确率下降了 6%;
- Ramp 报告称,在其 SWE-Bench 场景中,成本降低 58%,运行时间减少 33%,同时匹配前沿模型表现。
这些结果说明模型路由有潜力,但它们来自 NVIDIA 及合作方披露,并不是对所有任务的独立保证。尤其要注意 LangChain 的结果并非“质量完全不变”,而是用 6% 的准确率差异换取明显的成本下降。
评估路由器时,至少要同时看四项指标:正确率、端到端延迟、完整任务成本和失败后的恢复成本。只比较单个 token 价格,往往会漏掉路由判断和重试。
换模型会不会毁掉提示缓存
Hacker News 讨论中,争议最大的问题之一是提示缓存。批评者认为,同一会话不断切换模型,会让已经积累的 KV Cache 失效,抵消便宜模型省下的成本。
社区里也有人给出另一种解释:每个模型可以维护自己的缓存;重新切回某个模型时,只需要为它补上缺失的对话增量,而不是每次从头处理全部上下文。这样做仍然需要额外 prefill,而且缓存不能在结构不同的模型间直接共享,但较便宜模型承担更多生成工作后,整体仍可能节省费用。
这段讨论不能当作 Switchyard 的官方缓存承诺。它更像一个提醒:模型池大小、会话黏性、缓存策略和路由频率必须一起设计。模型选得越多,路由器越复杂,未必越划算。
新闻稿很积极,仓库却写着 pre-alpha
截至 2026 年 8 月 28 日,Switchyard 仓库仍把整个项目标为 pre-alpha,并提醒 API 和算法在 1.0 之前可能大幅变化。各组件的成熟度也不同:libsy 标为 Beta、可试验性集成;客户端和 runner 仍是 Alpha;switchyard-server 是演示服务器,明确不建议用于生产环境。
这与新闻稿中的“部署”“企业使用”并不完全矛盾:合作方可能使用的是内部集成、特定组件或受控试验,并不等于公开仓库中的演示服务器已经具备生产条件。对普通开发团队来说,更合理的起点是离线评测或旁路实验,而不是立刻替换线上网关。
真正动手前,先准备一张自己的路由表
如果要验证模型路由,可以从一个很小的模型池开始:一个擅长复杂规划的模型,一个便宜快速的执行模型,再加明确的升级条件。
建议先完成下面几件事:
- 从真实日志中整理任务类型,不要凭想象分类;
- 用同一批任务建立单模型基线,包括质量、延迟和总成本;
- 为每种路由结果记录选中了谁、为什么选、是否升级以及最终是否成功;
- 单独测量长会话下的缓存命中率和补齐成本;
- 为路由错误准备回退方案,并把重试也计入成本。
好的路由器不会一味选择最便宜的模型。它应当使用可验证的规则,把昂贵能力留给确实需要它的步骤。
收看本期节目
原始资料与延伸阅读
本文由《听懂 AI》第 002 期整理而成。节目讨论的主要来源是 NVIDIA 于 2026 年 8 月 11 日发布的 Nemotron 3.5 Lightning 与 NeMo Switchyard 资料,并加入了对项目成熟度、评测边界和 Hacker News 社区争议的核对。
- Kari Briski,NVIDIA,2026-08-11:NVIDIA Nemotron 3.5 Lightning and NeMo Switchyard Deliver Faster, Smarter, More Efficient Agentic AI
- Chris Alexiuk、Chintan Patel,NVIDIA Technical Blog,2026-08-11:NVIDIA Nemotron 3.5 Lightning Delivers Fast, Accurate Specialized Task Execution for Long-Running Agents
- NVIDIA-NeMo:Switchyard GitHub 仓库——功能、路由策略、许可证与成熟度说明。
- Hacker News:Nvidia Nemotron 3.5 Lightning and NeMo Switchyard——社区关于缓存、路由开销和产品成熟度的讨论;评论不代表已经验证的事实。
资料说明:性能和合作方数据主要来自 NVIDIA 官方材料,本文已保留测试主体、对照对象与准确率差异。关于缓存的内容来自社区讨论,只作为工程问题线索,不作为 Switchyard 的官方保证。

TL;DR:大语言模型并没有在脑中储存现成文章,它的核心机制是根据上下文反复预测下一个 token:这让它能流畅接话、解释概念,也解释了它为什么会在缺乏依据时,用同样笃定的口吻编造人名、论文和日期。理解这一点,就能理解它为什么“像人”,却并不可靠。
第一次和大语言模型聊天,很容易产生一种错觉:屏幕另一端像是坐着一个读过无数书、什么都能聊的人。它能续写邮件,能解释概念,也能顺着语气安慰你。可一旦追问一个冷门事实,它又可能用同样笃定的口吻编出不存在的人名、论文和日期。
这两种表现并不矛盾。要理解它,先放下“电子大脑”这个比喻,把它想成一位特别擅长接话、但不会自动查证的咖啡馆店员。
🎬 视频版(B站) | 🎧 音频版(4 分 14 秒)| 🟢 Spotify 订阅 | 📖 偏好阅读?文字版就在下方 👇
一句话版本:它在反复预测下一个 token
假设你说:“今晚下雨,出门记得带……”
人很容易想到“伞”。语言模型做的事情与此有一点相似,但规模大得多:它先把输入切成一组 token,再结合前面的上下文,为下一个 token 计算概率。选出一个之后,它把这个 token 加回上下文,继续预测下一个,直到回答结束。
token 不一定等于一个完整汉字或单词。它只是模型处理文字时使用的基本单位;具体怎样切分,取决于模型采用的分词方法。

图中的候选词和概率只是工作原理示意,不是某个真实模型的测量结果。
2017 年的论文 Attention Is All You Need 提出了 Transformer 架构。它通过注意力机制处理序列中不同位置之间的关系,后来成为大语言模型的重要技术基础。2020 年的 Language Models are Few-Shot Learners 则展示了 GPT-3 这类自回归语言模型在扩大参数和训练数据规模后,可以仅凭文字指令或少量示例完成多种任务。
所以,“预测下一个 token”听起来很朴素,却不代表模型只能做简单的句子补全。模型从大量训练文本中学到语法、文体、概念之间的关联,以及常见的推理表达方式。当这些规律共同参与一次预测时,结果就可能表现为写作、问答、翻译或代码生成。
它不是在脑中翻找一篇现成文章
另一个常见误解是:模型先把互联网背下来,回答时再从某个数据库里找到对应段落。
训练确实可能让模型记住部分内容,尤其是重复出现或具有独特表达的文本。但通常情况下,训练材料中的语言规律会被编码进大量参数。生成回答时,模型根据参数和当前上下文计算后续内容,不是在资料库中逐条检索。
这里需要区分基础语言模型和完整的 AI 产品。一个产品可以在模型外部接入搜索引擎、知识库、计算器或其他工具。此时你看到的答案可能同时包含模型生成和外部检索结果,但检索能力不是“预测下一个 token”天然附带的事实核验机制。
它会用语言,但“理解”仍有争议
模型能正确处理“下雨”和“带伞”的关系,是否就说明它理解雨是什么?
这个问题没有一句公认的结论。Emily M. Bender 和 Alexander Koller 在 2020 年的论文 Climbing towards NLU 中强调,学习语言形式与获得由现实经验支撑的意义不是一回事。模型可以熟练处理词语之间的关系,却没有淋雨、撑伞或被冷风吹过的身体经验。
另一方面,只用“随机鹦鹉”也不足以描述今天模型表现出来的全部能力。它确实掌握了强大的语言模式处理能力,但不能据此直接推断它拥有人的意识、感受或理解方式。
为什么它会一本正经地编答案
模型的基本目标是生成在当前上下文中看起来合适的后续,而不是保证每句话都经过外部证据核对。如果问题含糊、训练材料不足,或者错误说法在语料中很常见,它仍可能生成连贯但不真实的答案。
2021 年的 TruthfulQA 用 817 个问题测试模型是否会复述人类常见的错误观念。在当时接受评测的模型中,最佳结果有 58% 的回答被判定为真实,而人类基线为 94%。这组数字不能代表今天任何具体产品的水平,但它说明了一个长期存在的问题:语言流畅度和事实真实性不是同一个指标。
因此,遇到下面这些内容,不要因为语气自信就直接采用:
- 具体日期、数字、论文名称和引用;
- 医疗、法律、财务等高风险建议;
- 冷门人物、机构和历史事件;
- 无法打开或无法在其他来源中找到的链接。
普通人怎样用得更稳妥
把语言模型当成一个反应很快、知识面很广、但偶尔会硬撑的助理,通常比把它当成权威更合适。
适合交给它的工作包括改写文字、整理材料、列出备选方案、模拟提问和解释概念。涉及重要事实时,可以要求它区分“已知事实”“推测”和“不确定项”,列出可核验的来源,再由人打开原始资料确认。
提问也不需要背诵所谓的“提示词咒语”。说明读者是谁、想解决什么问题、有哪些限制,再给一个例子,往往就能明显改善结果。与此同时,不要随手提交身份证号、病历、公司机密或未公开代码;能否输入某类数据,应以所在组织的制度和所用产品的数据政策为准。
使用时记住:它很会生成答案,但“很像答案”不等于“答案是真的”。
收看本期节目
视频版
原始资料与延伸阅读
本文由《听懂 AI》第 001 期访谈整理而成。该期节目从科普主题出发,并非改写某一篇原文;文末补充了 Transformer、GPT-3、语言理解争议和真实性评测的原始论文。
- Ashish Vaswani 等,2017:Attention Is All You Need——Transformer 架构原始论文。
- Tom B. Brown 等,2020:Language Models are Few-Shot Learners——GPT-3 与少样本学习论文。
- Emily M. Bender、Alexander Koller,2020:Climbing towards NLU: On Meaning, Form, and Understanding in the Age of Data——语言形式、意义与“理解”的讨论。
- Stephanie Lin、Jacob Hilton、Owain Evans,2021:TruthfulQA: Measuring How Models Mimic Human Falsehoods——语言模型真实性评测。
资料说明:节目第 001 期原始 sources.json 只记录了“向不懂技术的人解释大语言模型”这一主题,没有外部 URL。以上论文由本文编辑阶段补充,用于说明相关技术背景和争议,不代表节目逐句改写这些论文。

最近看了 Matt Pocock 的一段视频:
视频只有 15 分钟,讲的却不是某个新模型或提示词技巧,而是一个更基础的问题:让 AI 参与一个已有代码库时,怎样避免每次都从头解释业务名词和历史决定?
Matt 之前的 /grill-me 会持续追问,把模糊的想法问到可以执行。它并没有失效;问题在于,单靠一轮轮问答,已经确认过的概念不会自动成为项目的一部分。下一次会话里,人仍可能要解释“独立视频”到底指什么、某个对象之间是一对一还是一对多、这个状态能否随意切换。
他现在在编码场景中改用 /grill-with-docs。它保留追问,但把共同语言和不容易看懂的决策写进仓库。这样,聊天记录不再是唯一的上下文。
单纯追问,为什么还不够
视频中的例子是一项新功能:在一个管理课程和视频的应用里加入 pitch。这里的 pitch 不是代码里的通用术语,而是视频的“包装”——标题、描述和对外呈现方式;团队会先想出多个 pitch,再选择其中一些制作成视频。
人一听就能根据上下文补全很多含义,AI 却没有这种默认背景。例如:
standalone video是不属于课程或课时的视频,还是“尚未关联 pitch 的视频”?- 一个 pitch 能否对应多个视频?一个 pitch 是否可以暂时没有视频?
- 删除 pitch 时,是连带删除、禁止删除,还是归档?
idle、scheduled、shipped是强制流转的状态机,还是可以手动修改的标签?
这些不是措辞洁癖。它们会影响数据库关系、删除规则、变量名、文件名、界面分组和后来的人怎样理解代码。若定义只存在于某次聊天里,之后每一次让 AI 修改相关部分,都会重新产生猜测空间。
把“共同语言”写成 context.md
/grill-with-docs 借用了领域驱动设计(DDD)中的“通用语言”思路。它会先寻找 context.md,读取其中的术语和定义;在对话中发现概念不清、用词冲突或新规则时,再要求人确认并更新这份文件。
在视频里,context.md 至少承担三件事:
- 说明这个代码库在解决什么问题;
- 定义关键实体、状态和关系,例如课程、版本、独立视频与 pitch;
- 为不熟悉项目的人和 AI 提供同一份可查阅的词汇表。
它不需要写成一份覆盖全部实现的百科全书。视频里的建议更接近 DDD 的 bounded context:一个大型 monorepo 可以有 context map 和多个上下文;如果一个仓库内大家说的是同一种业务语言,一份放在根目录的 context.md 就够用。
关键不在文件名,而在约束:产品、代码和与 AI 的对话尽量用同一个词。否则,文档里叫“已投递视频”,数据库表叫 standalone_videos,界面又叫“提案视频”,AI 很难判断它们到底是不是同一个东西。

共同语言需要在每次新需求中核对和更新;它不是一次写完就不再变化的说明书。
先核对词义,再讨论实现
/grill-with-docs 不会读完文档就直接生成代码。它会先把新需求同既有术语表对照,指出含义不清或冲突的地方,并通过具体场景把问题问出来。
视频的演示依次确认了:
- pitch 与独立视频是一对多关系;
- 有 pitch 的视频仍属于独立视频,pitch 是它的元数据,而不是另一类视频;
- pitch 允许暂时不关联任何视频;
- 状态目前可手动调整,自动流转以后再加;
- 由于作者更倾向归档而非删除,删除关系选择限制删除。
这些回答随后写回 context.md。作者也展示了一个很现实的细节:写入后产生了 pitched standalone video、unattached standalone video 之类别扭的名称。他没有假装第一版术语一定正确,而是提醒自己在“足够清楚”时停止讨论,后续需要时再重构。
这条边界很重要。共同语言的目的不是无限讨论命名,而是让接下来的实现少一点误解。
还有一类信息:为什么当时这样选
词汇表能定义“是什么”,却不总能解释“为什么”。视频把这类信息交给 ADR(Architecture Decision Record,架构决策记录)。
ADR 适合记录那些不看背景会觉得奇怪、又难以轻易撤回的选择:它面临过什么取舍、会带来什么后果。库选型这类容易替换的决定未必值得专门写 ADR;删除策略、数据关系或会影响多个模块的业务定义,通常更值得留下理由。
这也避免 AI 看到一个非直觉的实现时,自作主张把它“优化”掉。它能先读到决策背景,再判断当前需求是否真的要求改变它。

context.md 保存“是什么”,ADR 保存“为什么这样选”。
确认过的含义怎样留在项目里
Matt 的观察是:定义稳定后,AI 不必反复解释同一个概念,回复会更简洁;代码中的命名和规划文档也会更容易互相检索。这是他在工作流中的经验,而不是对所有模型和项目都成立的性能测试结果。
确认过的业务含义不必停在对话记录里。把它记录到仓库后,下一位开发者、下一次会话和后续生成的代码,都从同一份上下文开始。
从视频可以整理出一套小而可用的做法:
- 新功能开始时,只列出会影响数据、界面或规则的核心名词;
- 为每个名词写简短定义,并给一个能区分边界的例子;
- 让 AI 先检查这些词与现有代码、文档是否冲突,再进入实现;
- 把难以撤回的决定和取舍写成 ADR;
- 当名称已经能支持当前工作时继续开发,别为了完美命名无限停留。
这里的重点不是复制某个斜杠命令。即使不用这两个 skill,团队也可以建立同样的习惯:把 AI 提出的关键歧义当作待确认的产品或技术问题;确认后更新共享文档,而不是只在聊天窗口里回答一次。
/grill-me 并没有被淘汰
视频最后给出了一条很清楚的使用边界:有代码库时,优先用 /grill-with-docs;没有代码库的开放式任务,则继续用 /grill-me。作者还举了非工程场景的例子:有人用后者整理为母亲写悼词时的回忆,价值就在于耐心追问,而不是建立术语表。
项目刚开始时,作者仍倾向 /grill-with-docs,因为这恰好是最需要建立共同语言的阶段。差别不在于有没有足够多的代码,而在于这次对话是否要留下能被后续工作复用的领域知识。
让 AI 写代码之前,把项目里的词说清楚,看起来比直接输入需求慢一点。但当这些词会进入表名、组件名、接口和用户界面时,早一点确认往往比之后在许多文件里改名更便宜。

两个账号应各自使用独立的本地状态目录;它们可以同时工作,但不共享认证和会话。
一个人同时有个人和工作两个 OpenAI 账号时,最容易踩的坑不是登录,而是登录之后。默认情况下,Codex CLI 把认证、配置、会话和本地状态都放在同一个目录。后一次登录会让下一次启动的 CLI 使用新的身份;MCP、插件和会话历史也混在一起。
我在 macOS 上用 codex-cli 0.145.0 核对过这个行为。Codex 的配置源码把 CODEX_HOME 定义为全部本地状态的根目录:默认是 ~/.codex,设置后会改用指定目录。源码中的说明 也说明日志和 SQLite 状态会随这个目录变化。
这意味着可以把“个人”和“工作”当成两套独立的 CLI 环境,而不是在同一套配置里反复登录、退出。
这不是原生的多账号切换
先把边界说清楚。Codex CLI 还没有类似 --account work 的正式账号选择器;官方仓库中相应的功能请求仍是开放状态。该请求 本身也把现状描述为:默认只有一个本地状态目录,多账号只能换目录、换认证文件或重新登录。
所以 CODEX_HOME 的作用不是把两个账号放进一个账号列表里。它做的是把两套状态彻底分开:
- 个人账号有自己的认证、配置、MCP、Skills、插件和会话记录;
- 工作账号也有自己的一套;
- 两个终端可以同时运行,各自读取自己的 SQLite 状态库;
- 已经启动的 Codex 不会在运行中切换身份。要换账号,必须从对应入口启动新的 CLI 进程。
这比手动替换 ~/.codex/auth.json 稳妥得多,也更容易查清一条会话究竟用了哪个身份。
建两个独立目录,再分别登录
下面示例用两个目录保存状态。目录名只表示用途,不会把账号名称传给 OpenAI:
mkdir -p "$HOME/.codex-profiles/personal" "$HOME/.codex-profiles/work"

# 首次使用个人环境时登录个人账号
CODEX_HOME="$HOME/.codex-profiles/personal" codex login

# 首次使用工作环境时登录工作账号
CODEX_HOME="$HOME/.codex-profiles/work" codex login
以后从相同的入口启动即可:
# 个人环境
CODEX_HOME="$HOME/.codex-profiles/personal" codex

# 工作环境
CODEX_HOME="$HOME/.codex-profiles/work" codex
登录完成后,分别检查状态:
CODEX_HOME="$HOME/.codex-profiles/personal" codex login status
CODEX_HOME="$HOME/.codex-profiles/work" codex login status
如果日常经常在两个环境间切换,可以给终端写两个别名或两个很短的启动脚本。关键不是别名的名字,而是每个入口固定指向一个目录。涉及外部操作,例如创建 PR、发消息或使用带权限的 MCP 工具时,先看当前终端来自哪个入口。
不要复制或软链接 auth.json
看上去最快的做法,是先在默认目录登录一次,再把 auth.json 复制到另一个目录。这个方法不可靠。

复制的认证文件可能在另一个副本刷新 refresh token 后失效;两个目录应分别登录。
Codex 使用的 OAuth refresh token 可能是一次性的:当一个副本刷新 token 后,另一个副本里的旧 token 会失效。官方仓库已有复现说明:复制认证文件后,第一次可能还能使用缓存的 access token,之后可能出现 401。问题 #15410 还明确指出,用软链接或复制文件来共享 ChatGPT 订阅认证都不是稳定方案。
每个目录各自执行一次 codex login。不要从另一套环境复制认证文件,也不要把认证文件纳入 Git、网盘同步或备份脚本。
配置隔离带来的实际影响
账号隔离不是只多两个 auth.json。新目录一开始没有你原来配置过的 MCP server、插件、Skills、偏好设置或历史会话。这既是代价,也是这个办法有用的原因。
我通常会把配置分成两类:
- 与身份无关、也不含密钥的通用设置,可以用一个受版本控制的模板维护;
- 包含公司地址、MCP OAuth 登录状态、访问令牌或本机路径的设置,只放在对应环境里。
这样做的好处是,工作账号不会意外加载个人的高权限工具,个人会话也不会写进公司的历史记录。代价是第一次使用时要分别安装或配置真正需要的工具。
要注意,本文只讨论从终端启动的 Codex CLI。桌面端、IDE 扩展和其他 GUI 进程未必会继承终端环境变量;不能因为 CLI 被隔离,就假定它们也已经切换到同一账号。它们应单独核对登录状态和凭据位置。
适合的使用场景和不适合的使用场景
这个办法适合把合法且明确授权的身份分开,例如个人订阅与公司账号、两个客户提供的独立账号,或需要避免配置互相污染的测试环境。
它不应用于自动探测额度、在账号受限后自动切到下一个账号,或把多个账号的额度当作一份可轮换的资源。OpenAI 的服务条款禁止规避速率限制、使用限制和保护措施;个人账号也不应与他人共享凭据。OpenAI Terms of Use
如果目标只是让日常开发时的个人、工作上下文互不干扰,两个目录、两次独立登录和两个固定启动入口已经够用。它没有魔法,也不会扩大任何一个账号的权限或额度;它只是把本来会混在一起的本地状态分开保存。
**来源与核验范围:**本文基于 codex-cli 0.145.0 在 macOS 上的本地检查,以及 OpenAI 公开的 Codex 配置源码、多账号需求讨论、认证文件复制问题 和 服务条款。Codex 的行为和条款可能更新;实际配置前请以本机 codex --help 与当前条款为准。
2015 年,我做过一款很小的 iOS App,中文名叫「闪印」。它只解决一件事:把旅行、采购或工作清单整理好,预览,然后打印到纸上。
旧版用 Objective-C 和 Storyboard 开发,后来陆续支持了 iPad、iPhone Xs Max 和 iCloud。它没有复杂的账号系统,也不试图成为项目管理工具。清单建好,纸张打出来,任务就完成了。
十一年后,我重新打开这个项目,决定用 SwiftUI 把它重写一遍。新版项目叫 PrintableCheckList-SwiftUI,代码已经开源。
这次重写不是给旧界面换一层 SwiftUI。我要保留原来的用途,也要回答一个新问题:如果 AI 能帮人省掉大量录入工作,一份「可打印清单」今天应该怎么做?
它现在能做什么
PrintableCheckList 仍然可以完全手动使用。你可以创建多份清单,一次粘贴多行内容,编辑、删除或拖动排序,再生成带方框的打印预览,通过 iOS 系统打印控制器输出。
AI 是可选的快捷入口。比如输入:
生成一份带孩子去北海道旅行 7 天的冬季行李清单,需要考虑滑雪和儿童常用药。
App 会返回清单标题和项目。结果不会立刻写入数据,而是先进入编辑页;你可以改标题、删掉不需要的内容、补上个人物品,确认以后再保存。AI 也能给现有清单补充遗漏项,不必每次从头生成。
整个过程可以概括为:
输入主题
  ↓
按需联网搜索
  ↓
模型返回结构化 JSON
  ↓
去重、限长、清理序号
  ↓
用户检查和修改
  ↓
保存到本地 → 预览 → 打印
这里最重要的一步不是「生成」,而是生成后的确认。模型负责减少输入,用户仍然决定最后打印什么。
清单不只是待办事项
接入 AI 时,我很快遇到一个看似简单的问题:用户说「全球票房前十名」时,他要的是十部电影,不是「查询票房」「核对排名」之类的十个任务。
因此,内置提示词会区分两类内容:
- 准备事项、操作步骤和计划,要生成简短、可执行的清单项;
- 排行榜、目录和资料列表,要直接返回条目本身,并保留顺序和用户指定的数量。
模型必须返回固定的 JSON 结构。App 还会清理 Markdown 围栏、编号和重复内容,限制标题与项目长度。补充已有清单时,已经存在的项目也会被过滤掉。
这些处理不显眼,却决定了 AI 生成的内容能不能真正进入一个普通 App,而不是停留在聊天窗口里。
给时效性问题增加联网查证
旅行行李清单通常不需要搜索,但「最新票房排行」「最近发布的产品」或「当前汇率」不同。只靠模型已有知识,很容易得到过期答案。
PrintableCheckList 提供三种搜索模式:
- 自动:识别排行、新闻、天气、价格等时效性主题,只在需要时搜索;
- 始终搜索:每次生成前都先查资料;
- 关闭:直接使用模型生成。
目前 GLM 通过 Web Search API 搜索,OpenAI 通过 Responses API 的 Web Search 搜索。搜索结果会先整理成一段带来源的材料,再交给清单生成器。结果页显示来源链接,但来源不会混进最终的清单项。
DeepSeek 和自定义 OpenAI 兼容服务仍可生成清单,只是不启用这条原生搜索路径。这样没有假设所有 /chat/completions 服务都支持同一种联网工具。
BYOK:API Key 留在用户设备上
新版采用 BYOK(Bring Your Own Key)模式。用户可以选择 GLM、OpenAI、DeepSeek,或填写自己的 OpenAI 兼容服务地址和模型名称。
API Key 存在 iOS Keychain,访问级别为 WhenUnlockedThisDeviceOnly。普通配置存入 UserDefaults,但不会包含 Key。生成请求和必要的搜索请求由设备直接发给用户选择的服务商,不经过开发者服务器。
没有配置 AI 也不影响手工创建、编辑、预览和打印。我坚持保留这条边界。AI 应该缩短输入时间,不应该变成打开清单 App 的通行证。
本地优先,也照顾旧用户的数据
每次编辑都会先保存到设备的 Application Support/PrintableCheckList/projects.json。没有网络时,清单的创建、修改和打印都能继续使用。
可选的 iCloud 路径使用 NSUbiquitousKeyValueStore,沿用旧版的 keyProjects。代码也保留了原来的 bundle identifier,并实现了 NSKeyedArchiver 迁移:旧 Objective-C 里的 Project 和 Item 会转换成新的 Codable Swift 模型;旧 ID 不是 UUID 时,则生成稳定的 UUID。
这部分比重新画界面麻烦得多,却是一次真正的 App 更新必须承担的责任。重写代码不应该等于让用户重新输入数据。
需要说明的是,未签名模拟器不能代替真实 iCloud 环境。仓库已经覆盖旧数据导入和同步逻辑测试,但签名真机上的 iCloud 端到端验证仍然是发布前检查项。
打印仍然是主角
虽然新版加入了 AI,项目名称里的 Printable 没有变。
预览页使用 SwiftUI 显示标题、项目和空白方框;真正打印时,App 生成一段经过 HTML 转义的排版内容,再交给 UIPrintInteractionController。iPad 上还单独处理了打印弹窗的锚点,避免 popover 因缺少来源视图而崩溃。
测试中还会把默认中文旅行清单交给打印格式化器,确认它能排在一张 A4 纸内。相比「按钮能点」,这更接近 PrintableCheckList 真正要完成的事情。
工程本身也换了一种维护方式
新版最低支持 iOS 17,使用 SwiftUI 和 Swift Concurrency。工程文件由 XcodeGen 根据 project.yml 生成,.xcodeproj 不进入版本库。生成、构建、测试、模拟器运行和归档分别有独立脚本,日常开发不必手动维护 Xcode 工程里的文件引用。
截至 2026 年 7 月 22 日,我在 iPhone 16 Pro / iOS 18.5 模拟器上执行了完整测试:42 个测试用例中,41 个通过,1 个 Keychain 用例因为无签名模拟器缺少 entitlement 而按预期跳过。覆盖范围包括:
- 清单的创建、编辑、排序、持久化和旧数据迁移;
- 打印内容转义与 A4 分页;
- AI 配置、Key 隔离、响应解析、去重和错误映射;
- GLM 与 OpenAI 的联网搜索请求和来源解析;
- 手工创建、AI 新建、AI 补充、取消、失败重试和设置页等 UI 流程。
本地运行
需要 macOS、Xcode、iOS 模拟器和 XcodeGen。克隆后运行:
git clone https://github.com/terryso/PrintableCheckList-SwiftUI.git
cd PrintableCheckList-SwiftUI
./Scripts/generate.sh
./Scripts/build.sh
执行完整测试:
./Scripts/test.sh
安装并启动模拟器版本:
./Scripts/run-simulator.sh
AI 配置不是运行项目的前提。你可以先把它当作一款普通的本地清单 App,之后再决定要不要填入自己的 API Key。
写在最后
软件重写很容易让人只关注新框架、新界面和新功能。但回到 PrintableCheckList,真正不能丢的只有两件事:旧数据还在,清单还能顺利打印。
SwiftUI 让界面和状态管理简单了很多,AI 让创建清单更快,联网搜索让时效性内容有了核对来源。不过这些能力最后都服务于一个很朴素的动作:拿起一张纸,照着清单去做事。
如果你是 Swift 开发者,又想把自己 Mac 上的能力(本地文件、Shortcuts、Xcode 项目、Core Data 数据……)暴露给 Claude、ChatGPT 这类 AI 助手,那么 MCP Server 就是你要的东西。而目前主流的 MCP 教程几乎都是 Python 或 TypeScript,Swift 版本极少——这也让 “swift mcp server” 成为一个几乎无人竞争的关键词。
本文用一个能跑通的最小示例,带你从零构建一个 Swift MCP Server,并接入 Claude Desktop。
什么是 MCP Server?
Model Context Protocol (MCP) 是 Anthropic 在 2024 年底提出的开放协议,用来标准化 “LLM 应用 ↔ 外部工具/数据源” 之间的通信。你可以把它理解成 “AI 应用的 USB-C”:
- MCP Host:AI 应用(Claude Desktop、Cursor、Codex CLI……)
- MCP Client:Host 内部为每个连接建立的会话客户端
- MCP Server:你写的进程,向 Host 暴露
tools、resources、prompts
协议本体是基于 JSON-RPC 2.0 的双向消息,通过两种传输承载:
| 传输 | 场景 | 特点 |
|---|---|---|
| stdio | 本地进程,Host 直接 spawn | 简单、零配置、无网络暴露 |
| Streamable HTTP / SSE | 远程或跨机器 | 需 Accept: application/json, text/event-stream |
对本地 Mac 工具来说,stdio 是默认选择。
为什么用 Swift 写 MCP Server?
多数教程默认 Python/Node,但用 Swift 有几个独特优势:
- 原生调用 macOS API:EventKit、Contacts、AppKit、Core Data、Shortcuts、ScreenCaptureKit……不需要 shell 桥。
- 单文件可执行:
swift build -c release产出一个静态二进制,Claude Desktop 直接 spawn,无 Python 环境依赖。 - 强类型 + async/await:JSON-RPC 消息用
Codable+enum建模,工具 handler 天然并发安全。 - 和 Xcode / SwiftUI 项目共享代码:同一份
Package里既能被 App target 用,也能被 MCP server target 用。
架构总览
一个最小可用的 Swift MCP Server 包含四层:
┌─────────────────────────────┐
│  Claude Desktop (Host)      │
└──────────────┬──────────────┘
        stdio  │  JSON-RPC 2.0
┌──────────────▼──────────────┐
│  Transport  (stdin/stdout)  │  按行读、按行写
├─────────────────────────────┤
│  JSON-RPC Dispatcher        │  method → handler
├─────────────────────────────┤
│  MCP Protocol Layer         │  initialize / tools/list / tools/call
├─────────────────────────────┤
│  Your Tools                 │  echo / read_notes / run_shortcut ...
└─────────────────────────────┘
项目搭建
新建一个 Swift Package:
mkdir SwiftMCPDemo && cd SwiftMCPDemo
swift package init --type executable
编辑 Package.swift(macOS 13+,用到 AsyncStream 与 Foundation 的 JSON 编解码):
// swift-tools-version:5.9
import PackageDescription

let package = Package(
    name: "SwiftMCPDemo",
    platforms: [.macOS(.v13)],
    targets: [
        .executableTarget(name: "SwiftMCPDemo", path: "Sources/SwiftMCPDemo")
    ]
)
第一步:JSON-RPC 消息建模
MCP 的每条消息都是 JSON-RPC 2.0。用 Codable 把请求 / 响应 / 错误建模一次,后面所有 handler 都复用:
import Foundation

struct RPCRequest: Decodable {
    let jsonrpc: String
    let id: JSONValue?      // 可能是 number / string / null(通知无 id)
    let method: String
    let params: JSONValue?
}

struct RPCResponse: Encodable {
    let jsonrpc = "2.0"
    let id: JSONValue?
    var result: JSONValue?
    var error: RPCError?
}

struct RPCError: Encodable {
    let code: Int
    let message: String
    var data: JSONValue?
}

/// 一个能表达任意 JSON 的枚举,避免到处写 [String: Any]
enum JSONValue: Codable {
    case null
    case bool(Bool)
    case int(Int)
    case double(Double)
    case string(String)
    case array([JSONValue])
    case object([String: JSONValue])

    init(from decoder: Decoder) throws {
        let c = try decoder.singleValueContainer()
        if c.decodeNil() { self = .null; return }
        if let v = try? c.decode(Bool.self) { self = .bool(v); return }
        if let v = try? c.decode(Int.self) { self = .int(v); return }
        if let v = try? c.decode(Double.self) { self = .double(v); return }
        if let v = try? c.decode(String.self) { self = .string(v); return }
        if let v = try? c.decode([JSONValue].self) { self = .array(v); return }
        if let v = try? c.decode([String: JSONValue].self) { self = .object(v); return }
        throw DecodingError.dataCorruptedError(in: c, debugDescription: "Unsupported JSON")
    }

    func encode(to encoder: Encoder) throws {
        var c = encoder.singleValueContainer()
        switch self {
        case .null: try c.encodeNil()
        case .bool(let v): try c.encode(v)
        case .int(let v): try c.encode(v)
        case .double(let v): try c.encode(v)
        case .string(let v): try c.encode(v)
        case .array(let v): try c.encode(v)
        case .object(let v): try c.encode(v)
        }
    }
}
第二步:stdio 传输层
MCP over stdio 用 换行分隔的 JSON(每条消息一行)。关键点:
- 所有日志必须写 stderr,不能污染 stdout;
- 读取用行缓冲,避免半条 JSON。
actor StdioTransport {
    private let stdin = FileHandle.standardInput
    private let stdout = FileHandle.standardOutput

    func readLines() -> AsyncStream<Data> {
        AsyncStream { continuation in
            Task.detached {
                var buffer = Data()
                while let chunk = try? self.stdin.read(upToCount: 4096), !chunk.isEmpty {
                    buffer.append(chunk)
                    while let nl = buffer.firstIndex(of: 0x0A) {
                        let line = buffer.subdata(in: 0..<nl)
                        buffer.removeSubrange(0...nl)
                        if !line.isEmpty { continuation.yield(line) }
                    }
                }
                continuation.finish()
            }
        }
    }

    func send(_ response: RPCResponse) throws {
        var data = try JSONEncoder().encode(response)
        data.append(0x0A) // '\n'
        try stdout.write(contentsOf: data)
    }
}

func log(_ msg: String) {
    FileHandle.standardError.write(Data("[mcp] \(msg)\n".utf8))
}
第三步:注册工具
定义一个 Tool 协议,让每个工具自描述 schema 并处理调用:
protocol Tool: Sendable {
    var name: String { get }
    var description: String { get }
    var inputSchema: JSONValue { get }   // JSON Schema
    func call(arguments: JSONValue) async throws -> JSONValue
}

struct EchoTool: Tool {
    let name = "echo"
    let description = "Echo the input text back to the caller."
    let inputSchema: JSONValue = .object([
        "type": .string("object"),
        "properties": .object([
            "text": .object([
                "type": .string("string"),
                "description": .string("Text to echo back.")
            ])
        ]),
        "required": .array([.string("text")])
    ])

    func call(arguments: JSONValue) async throws -> JSONValue {
        guard case .object(let obj) = arguments,
              case .string(let text) = obj["text"] ?? .null else {
            throw NSError(domain: "echo", code: 1,
                          userInfo: [NSLocalizedDescriptionKey: "missing `text`"])
        }
        // MCP tool 返回的是 content 数组
        return .object([
            "content": .array([
                .object([
                    "type": .string("text"),
                    "text": .string(text)
                ])
            ])
        ])
    }
}
第四步:Dispatcher 与 MCP 生命周期
MCP 一次会话至少要处理三个方法:initialize、tools/list、tools/call。
final class Server {
    let transport = StdioTransport()
    var tools: [String: any Tool] = [:]

    func register(_ tool: any Tool) { tools[tool.name] = tool }

    func run() async {
        for await line in await transport.readLines() {
            await handleLine(line)
        }
    }

    private func handleLine(_ data: Data) async {
        guard let req = try? JSONDecoder().decode(RPCRequest.self, from: data) else {
            log("bad json: \(String(data: data, encoding: .utf8) ?? "?")")
            return
        }

        var resp = RPCResponse(id: req.id)
        do {
            switch req.method {
            case "initialize":
                resp.result = .object([
                    "protocolVersion": .string("2025-06-18"),
                    "capabilities": .object([
                        "tools": .object([:])
                    ]),
                    "serverInfo": .object([
                        "name": .string("swift-mcp-demo"),
                        "version": .string("0.1.0")
                    ])
                ])

            case "tools/list":
                let list = tools.values.map { t in
                    JSONValue.object([
                        "name": .string(t.name),
                        "description": .string(t.description),
                        "inputSchema": t.inputSchema
                    ])
                }
                resp.result = .object(["tools": .array(list)])

            case "tools/call":
                guard case .object(let p) = req.params ?? .null,
                      case .string(let name) = p["name"] ?? .null,
                      let tool = tools[name] else {
                    throw NSError(domain: "mcp", code: -32601,
                                  userInfo: [NSLocalizedDescriptionKey: "tool not found"])
                }
                let args = p["arguments"] ?? .object([:])
                resp.result = try await tool.call(arguments: args)

            case "notifications/initialized":
                return   // 通知无需回复

            default:
                resp.error = RPCError(code: -32601, message: "method not found: \(req.method)")
            }
        } catch {
            resp.error = RPCError(code: -32000, message: "\(error)")
        }

        if req.id != nil {
            try? await transport.send(resp)
        }
    }
}
main.swift 里把它跑起来:
@main
struct App {
    static func main() async {
        let server = Server()
        server.register(EchoTool())
        log("swift-mcp-demo starting on stdio")
        await server.run()
    }
}
编译:
swift build -c release
# 产物路径
echo "$(pwd)/.build/release/SwiftMCPDemo"
接入 Claude Desktop
编辑 ~/Library/Application Support/Claude/claude_desktop_config.json:
{
  "mcpServers": {
    "swift-demo": {
      "command": "/绝对路径/SwiftMCPDemo/.build/release/SwiftMCPDemo"
    }
  }
}
重启 Claude Desktop。在对话框输入框左下角的 🔌 图标里应能看到 echo 工具。让 Claude 调用:
用 echo 工具回显 “Hello from Swift MCP”。
如果一切正常,Claude 会把返回内容展示回来。
常见坑
- stdout 被日志污染:任何
print都会破坏 JSON-RPC 帧。所有日志一律走 stderr。 - 忘记
notifications/initialized:Host 发来的通知没有id,如果你也回一个响应会让客户端报协议错。判断req.id != nil再发送。 - schema 与 arguments 不一致:
inputSchema里声明的required字段必须真的能从arguments里拿到,否则 Host 会跳过工具或报错。 - 权限提示卡住:如果工具触及通讯录、日历、屏幕录制等,第一次运行会弹系统授权;Claude Desktop 是无窗口 spawn,用户可能看不到——先在终端里手动跑一次触发授权。
- remote / SSE 传输:Streamable HTTP 的 POST 必须带
Accept: application/json, text/event-stream,否则官方 SDK 直接 406。stdio 走不通再考虑升级到 HTTP。
常见问题(FAQ)
Q:Swift MCP Server 能跨平台跑吗?
可以。核心代码只依赖 Foundation,Linux 上的 Swift 5.9+ 也能编译;要触达 macOS 专属 API(EventKit 等)时才会被平台绑定。
Q:需不需要自己实现 JSON-RPC,社区有没有现成库?
有官方 Swift SDK(modelcontextprotocol/swift-sdk)。生产项目直接用它;本文手写是为了把协议讲透。
Q:MCP Server 支持流式返回吗?
支持。工具可以在长任务里通过 notifications/progress 推进度,但要小心:客户端普遍有 30~60 秒左右的调用超时,超长任务应拆成 “创建 job → 查询结果” 两个工具。
Q:怎样调试?
最简单的办法:用 mcp-inspector(npx @modelcontextprotocol/inspector /path/to/SwiftMCPDemo)在浏览器里逐条查看请求与响应。
Q:MCP 会不会被 CLI 工具替代?
围绕 CLI vs MCP 有过一场讨论,但对于强类型、需要 schema 的 macOS 原生能力,MCP 仍然是最合适的封装。
结论
Swift + MCP 是被严重低估的组合:一份 Swift Package 就能把 macOS 原生能力干净地暴露给任何符合 MCP 的 AI 客户端,无 Python、无网络、类型安全。这篇教程的完整代码可以直接复制运行;下一步建议:
- 把
EchoTool换成RunShortcutTool,用Process调shortcuts run; - 加一个
read_notes工具走 AppleScript / EventKit; - 打包成
.pkg或 Homebrew tap,让别人一键装。
如果你在做类似方向的实验,欢迎订阅本站 RSS 或看看姊妹项目 Open Agent SDK (Swift),那边把 “Agent Loop + MCP 集成” 完整跑通了。
如果你看过我之前那篇 Story Automator 上手实录,应该还记得我最后的结论:
白天手工跑,目前还是自己手工跑会更快。但睡前把一批 Story 交给它过夜跑,这个场景它真的挺合适。
那篇文章里我留了个没回答的问题——为什么它跑得比人手工还慢? 我当时说"还没仔细分析它的实现原理"。
现在 BMAD 6.10 把这套东西重写了一遍,改名 BMAD Loop,也顺手把那个问题接上了。答案只有一句话,但它是理解整个设计的钥匙:
控制环里,不应该放 LLM。
先纠正一个最容易踩的误解
很多人第一次接触 BMAD Loop,会以为它是几个新 skill:bmad-loop-setup、bmad-loop-sweep、bmad-loop-resolve、bmad-dev-auto。
不是。这几个 skill 本身什么也不做。
真正驱动循环的,是一个用 uv 从 Git 装进来的 Python 工具——bmad-loop 包(仓库在 bmad-code-org/bmad-loop)。那几个 skill 只是编排器在循环的不同阶段会去调用的"基本操作"(官方文档里叫 primitive,说白了就是最基础的、可以单独派活的小单元):
bmad-dev-auto:开发——把意图变成经得起 review 的产物bmad-loop-sweep:巡检——清理延后工作台账bmad-loop-resolve:交互——和人一起消除歧义
换句话说,skill 是肌肉,Python 编排器才是中枢神经。 这一点想通了,后面所有设计都顺理成章。
灵魂信条:No LLM in the control loop
官方 README 的副标题一句话就给它定了性:
A deterministic ralph-loop orchestrator for the BMAD-METHOD implementation phase.
翻译过来:一个确定性的循环编排器。"确定性"(deterministic)这三个字是全文最重要的一组词。
它把整个开发循环切成两种完全不同的工作:
| 工作 | 谁来做 | 为什么 |
|---|---|---|
| 控制逻辑:选哪个 story、重试几次、什么算完成、能不能提交 | 纯 Python 代码 | 要确定、可调试、可复现、不花钱 |
| 创意工作:写代码、写测试、做对抗式 review | LLM(在一次性会话里) | 这才是 LLM 擅长、且只有 LLM 能做的事 |
回过头看 Story Automator 为什么慢——它的控制环里塞满了"用提示词去问 LLM 现在该干嘛"的环节。每问一次都要花 token、等推理,还可能跑偏,跑偏了就再问一次。把调度交给 LLM,等于让一个容易走神、按字计费的新人在流水线上当调度员。
BMAD Loop 的做法是:调度员换成一段不会走神、不收钱的 Python 代码,LLM 只在每个工位上干它该干的创意活,干完就走。

这样做换来四个好处,是后续所有机制的出发点:
- 确定性:同样的 sprint 跑两次,调度路径一致
- 可调试:流程是代码,出问题能打断点、看日志,而不是"猜提示词哪里没说清"
- 可复现:每次运行的决策都有磁盘上的状态机记录
- 省钱:控制逻辑零 token 消耗
四个让它"敢放手"的关键机制
"控制环不放 LLM"说起来轻松,但它带来一个尖锐的问题:编排器怎么知道一个 LLM 会话干完了、干对了? 旧做法是让编排器自己也是个 LLM,去"看"会话的输出——这正是 Story Automator 的包袱。
BMAD Loop 用四个机制绕开了这个包袱。
机制一:每个步骤都是全新上下文的一次性会话
Dev 和 review 是两个独立会话,review 会话绝不继承 dev 会话的上下文。
这一点反直觉,但极其关键。如果 review 会话带着 dev 写代码时的记忆,它天然会"护短"——人对自己刚写的代码容易先入为主、下不去狠手(心理学叫锚定效应,anchoring bias),LLM 也一样。把 review 放进一个对 dev 一无所知的全新会话里,它才会真的去挑刺,而不是附和。
类比:你不能让写代码的人和 code review 的人是同一个脑子。上下文隔离,就是给 review 配一双"没见过这份代码"的眼睛。
机制二:靠 hook 事件文件通信,绝不抓屏
编排器怎么知道会话结束了?答案是给 coding CLI(Claude Code / Codex / Gemini)注册 hook——Stop、SessionStart、SessionEnd、PreCompact。这些 hook 在关键节点往磁盘写结构化事件文件,编排器只管 watch 这些文件。
而每个 skill 在自动化模式下跑完,会写一个机器可读的 result.json,声明自己这一轮的产物和状态。
旧做法(Story Automator):         BMAD Loop 的做法:
┌─────────────┐                    ┌─────────────┐
│  编排器(LLM) │                    │ 编排器(Python)│
│   去看屏幕   │ ←脆弱、贵、易错      │  watch 文件  │ ←稳、免费、结构化
└─────────────┘                    └─────────────┘
       ↑                                  ↑
   抓 pane / 读对话                  读 Stop hook 写的事件
                                   读 skill 写的 result.json
抓屏(pane-scraping)是上一个时代的痛:终端输出格式一变、模型多说了一句废话,编排器就懵了。换成"hook 写文件、编排器读文件",接口就从自然语言降维成了结构化数据,鲁棒性立刻上一个台阶。
机制三:Trust nothing, verify everything
这是整个系统最硬核的地方。每个 LLM 会话结束后,编排器不信任会话自己说的"我搞定了",而是去磁盘上独立校验:
- spec frontmatter(文件开头的元信息)状态:story 的规格文件状态字段是否真的变成了 done
- baseline-commit 匹配:会话声称改了哪些文件,和 git 里实际的 diff 对不对得上——这是一个便宜的"LLM 撒谎检测器"
- 非空 diff:到底有没有真的改东西
- sprint-status 同步:状态文件是否和实际进度一致
- 你的测试 / lint 命令:最后提交前,跑一遍你自己定义的测试和 lint
校验全过,才允许 commit。任何一项不过,要么重试,要么升级。
这条哲学值得单独记住:LLM 会幻觉,但 git 不会。 把"是否真的完成"这个判断,从"问 LLM"挪到"看磁盘证据",整个系统就稳了。
机制四:deferred-work 台账 + sweep,终于有人读它了
循环里总会遇到"现在干不了"的活——某个 edge case 要等另一个 story 先落地、某个决策该人来拍板。这些不能硬干,也不能丢,于是写进一份台账:deferred-work.md。
有意思的是这份台账的身世。在更早的 BMAD 版本里,这是个有名的半成品——bmad-code-review 会往 deferred-work.md 里写延后项,但没有任何 skill 会回头读它(社区甚至专门提了 issue 报这个 bug)。写进去的债,永远没人还。
BMAD Loop 的 bmad-loop-sweep 终于补上了这一环。它做的事是只读巡检:把台账里每条 open 的项,对着真实代码库逐条验证(grep 症状、查 git log、读相关文件),然后分成五类:
| 分区 | 含义 | 编排器怎么办 |
|---|---|---|
already_resolved |
后来的工作顺手解决了,但没标记 | 拿证据(file:line / commit)自动关掉 |
bundles |
现在就能一起干的,按相同文件/子系统打包成一个 dev 会话 | 执行 |
blocked |
得等某个未来的 story/epic 落地 | 标记阻塞方,挂着 |
skip |
已过时、无关、或项目明确排除 | 跳过 |
decisions |
必须人来拍板(改冻结 spec、改 API 形状等) | 升级给人 |
"写进去的债,有人还了"——而且是带着证据还,不是凭台账里的旧状态拍脑袋。这条机制让循环可以长时间无人值守地跑下去而不至于债台高筑。
一张图看清整个循环
把上面四个机制拼起来,一个 story 在 BMAD Loop 里的完整生命周期是这样的:

整条链路的控制流是 Python,只有②③④这几个"创意工位"是 LLM 在一次性会话里干活。这就是"确定性编排器"的完整含义。
多模型编排:三个 CLI,按角色混搭
BMAD Loop 通过一个通用的 tmux 适配器驱动三种 coding CLI:claude(默认)、codex、gemini。而且可以按阶段混搭——配置在项目的 .bmad-loop/policy.toml 里:
[adapter]
name = "claude"          # 默认所有阶段都用 claude

[adapter.review]
name = "codex"           # 但 review 阶段换成 codex
为什么要混搭?因为不同模型擅长的事不一样。一个很实用的组合是:让一个模型写代码、让另一个模型做对抗式 review——两个不同家族的模型互相挑刺,比同一个模型自审要狠得多。这正好和"机制一:review 用全新上下文"叠加,双重消除偏置。
这已经不是"调一个模型"了,是模型编排。
什么时候它会停下来叫你:CRITICAL 升级
无人值守不等于无人干预。有一种情况编排器会主动暂停整个 run,等人——CRITICAL 升级。
触发条件通常是:dev 或 review 会话发现冻结的 spec(<frozen-after-approval> 块)自相矛盾,或者对某个关键场景保持沉默,没法安全地继续。这时候它不猜、不硬干,而是把 run 挂起,等你用:
bmad-loop resolve --story <story-key>
起一个交互式会话。这个会话里有人(你),所以它会问你问题、给出 2-4 个具体选项和推荐。你拍板之后,它去改 spec 本身——不是改代码——把歧义消掉,然后编排器重新驱动这个 story,对着一份修正过的、没有矛盾的 spec 重跑。
这个设计很克制,有几条硬规矩值得点赞:
- resolve 会话只改 spec 内容,不写一行功能代码、不跑测试、不提交
- 它不动 sprint-status.yaml,也不设 spec 的 status 字段——这些由编排器在恢复时确定性地产出
- 如果信息不够、或者正确的修复超出了 spec 编辑的范围(比如需要改 PRD/架构),它会直接说"我解决不了",不写完成标记,run 继续挂着——这是安全的默认行为
一句话:遇到拿不准的,宁可停下来等你,也不编一个答案往下冲。 这是对"无人值守"最负责的理解。
怎么用:上手三步
前置条件就一条:你得有一个 BMAD v6 项目,而且 bmad-sprint-planning 已经跑过、生成了 sprint-status.yaml。换句话说,PRD / 架构 / epics&stories / sprint planning 这条链得先走完,Loop 才有故事可转。
装好之后(通过 bmad-loop-setup 这个 skill,它会从 Git 装 Python 工具 + 跑 bmad-loop init 注册 hook、铺 skill、写 policy.toml),核心命令其实很少:
bmad-loop init        # 装 bmad-loop-* skill + hook + policy.toml + gitignore
bmad-loop validate    # 预检:config / sprint-status / git / tmux / CLI / hook
bmad-loop run --dry-run   # 先打印计划,不真的拉起会话
bmad-loop run         # 开跑
bmad-loop tui         # 或者干脆全在可视化面板里操作
完整命令清单覆盖了 run / sweep / resume / resolve / decisions / status / attach / stop / clean 等,但日常 90% 的场景就是上面这几条。bmad-loop tui 那个仪表盘挺漂亮——run 选择器、sprint 树、deferred-work 台账、每个 story 的实时任务表、带颜色的日志流,一屏打尽。
一个必须知道的一次性设置坑:如果目标项目里 coding CLI 从来没跑过(比如 claude 没在这个目录启动过),你要先手动启动一次,接受 workspace-trust 和 hooks 审批对话框。编排器拉起的子会话没法替你点这些首次运行对话框,而一个挂着的对话框会被编排器误判成"会话超时"。
血统:从 Story Automator 到 BMAD Loop
把 BMAD Loop 放回时间线里,它的位置就很清楚了:
Story Automator          bmad-automator / bmad-auto          BMAD Loop
(2026 初, 我那篇          (中间的过渡形态,                  (6.10, 重写为
 实测的版本)               工具名 bmad-auto)                  确定性 Python 编排器)
      │                        │                                 │
      └──── 控制环里有 LLM ─────┴───── 重写 ────────► 控制环里没有 LLM ──┘
              (慢、贵、易跑偏)                         (确定、可调试、省钱)
README 里写得很坦诚:"Inspired by the original bmad-automator (a separate, legacy project)"——它明确把上一代当成 legacy,自己是从头来的重写。
而它给自己定位是 "a deterministic ralph-loop orchestrator"。如果你关注过 autonomous dev 这个圈子,应该听说过 Ralph——那个让 Claude Code 自己跑开发循环的工具。BMAD Loop 借用了"ralph-loop"这个模式(无人值守、反复迭代的小循环),但把它确定性地实现在了 BMAD 的 story 体系上。所以它是"Ralph 的精神 + BMAD 的骨架 + Python 的中枢"。
适合谁,不适合谁
延续我测评 Story Automator 时的坦诚基调,给你一个不吹的判断。
适合用的场景:
- 你已经完整走完 BMAD 的规划链(PRD → 架构 → epics → sprint planning),手头有一串清晰、可独立实现的 story
- 你接受"睡前梭一把"这种异步交付模式——第二天起来看结果,而不是盯着它实时干
- 你的项目有可靠的测试和 lint(机制三最后那道闸靠它们),否则 verify 形同虚设
- 你想做多模型互相 review,又不想自己手动切来切去
不适合 / 要谨慎的场景:
- story 还很模糊、依赖关系没理清——这种跑进循环里大概率触发一堆 CRITICAL 升级,反而更累
- 没有测试的项目——编排器再聪明,最后那道 verify 闸门空转,等于裸奔
- 期待它"又快又好又自动"——确定性编排让它更稳、更省,但单 story 的绝对速度未必比一个熟手手工盯更快。它的价值在批量、异步、可恢复,不在单点提速
和上一代最大的区别,也是我现在最看好它的一点:因为控制环是确定性代码,它可调试、可复现、可信任。Story Automator 时代那个"为什么这么慢"的黑盒,这一次终于打开了——流程是 Python,你看得到每一步在干嘛、为什么这么决策。光这一点,就值得把它从"试验品"升级成"可以认真用起来的工具"。
写在最后
从 v6.8 的"锁定意图"(让 AI 先搞懂你要什么),到 6.10 的 BMAD Loop(让确定性的代码当调度员、LLM 只管写代码),BMAD 这两年的演进方向其实非常一致:
把不该让 LLM 干的活,一件一件从 LLM 手里拿回来。
意图理解该锁定的,用 SPEC 锁定;调度该确定的,用 Python 确定;该人拍板的,挂起 run 等人。LLM 越来越被收敛到它真正擅长的那块创意工作上。
这不是对 LLM 不信任,恰恰是对它的尊重——别让它干它不擅长、又会幻觉、还按字收费的活。
如果你也在用 BMAD 做项目,强烈建议拿一个 sprint 来认真试一次 BMAD Loop。哪怕只是为了让 deferred-work.md 那本"永远没人还的债账"终于有人管,也值。
参考来源:
- bmad-loop 官方仓库:bmad-code-org/bmad-loop
- BMAD Method 文档:docs.bmad-method.org
- 上一代实测:BMAD Story Automator 上手实录
- v6.8 上下文:BMad v6.8:AI开发正式进入"锁定意图"时代
原文:When AI builds itself — Anthropic Institute
作者:Marina Favaro, Jack Clark | 发布于 2026 年 6 月
一句话总结
Anthropic 用自己内部的硬数据证明了:AI 正在加速 AI 的开发,而且加速度本身也在加快。从外部基准测试到内部工程效率,所有曲线都在上扬。递归自我改进——AI 完全自主地设计和开发自己的继任者——还没有实现,但可能来得比大多数机构准备好的时间更早。
进化的五个阶段
Anthropic 把这个过程分成了五个阶段:
| 阶段 | 时间 | 人类在做什么 | AI 在做什么 |
|---|---|---|---|
| 人工驱动 | 2021–2023 | 写代码、写文档 | 不存在 |
| 聊天助手 | 2023–2025 | 主导一切工作 | 生成代码片段,人类复制粘贴 |
| 编程 Agent | 2025–2026 | 审查和引导 | 独立写文件、编辑代码 |
| 自主 Agent | 今天 | 设定目标 | 自己跑代码,给其他 Agent 派活 |
| 闭环 | 20XX? | 监督与验证 | 自己训练和构建模型 |
这个阶段的划分不是理论推演,而是 Anthropic 内部真实发生的事情。注意最后那个 20XX?——连 Anthropic 自己都不确定时间点,但方向是明确的。
外部证据:基准测试的加速饱和
如果你只看公开数据,趋势同样惊人。
AI 能完成的任务时长每 4 个月翻一倍(之前是每 7 个月)。这是什么概念?
- 2024 年 3 月:Claude Opus 3 能完成人类约 4 分钟 的任务
- 2025 年 3 月:Claude Sonnet 3.7 搞定 1.5 小时 的任务
- 2026 年 3 月:Claude Opus 4.6 搞定 12 小时 的任务
- 如果趋势持续:2026 年内可能覆盖数天级别的任务,2027 年可能覆盖数周级别的任务
几个重要基准测试的状态:
- SWE-bench(真实世界的软件工程测试):两年内从个位数跑到饱和。模型拿到真实的开源代码库和真实的 bug 报告,自己写修复代码并通过项目测试
- CORE-Bench(复现已有研究):从 2024 年约 20% 的成功率,15 个月后饱和
- METR 长任务基准:Claude Mythos Preview 能连续工作至少 16 小时,已经触及 METR 能测量的上限
来自 Anthropic 内部的数据
公开基准测试能告诉你模型有多强,但看不到 AI 对 AI 开发本身的加速效应。Anthropic 这次公开了内部数据,这是这篇文章最有价值的部分。
80% 的代码由 Claude 编写
截至 2026 年 5 月,Anthropic 合并到代码库的代码中超过 80% 由 Claude 编写。Claude Code 在 2025 年 2 月发布之前,这个数字只有低个位数。
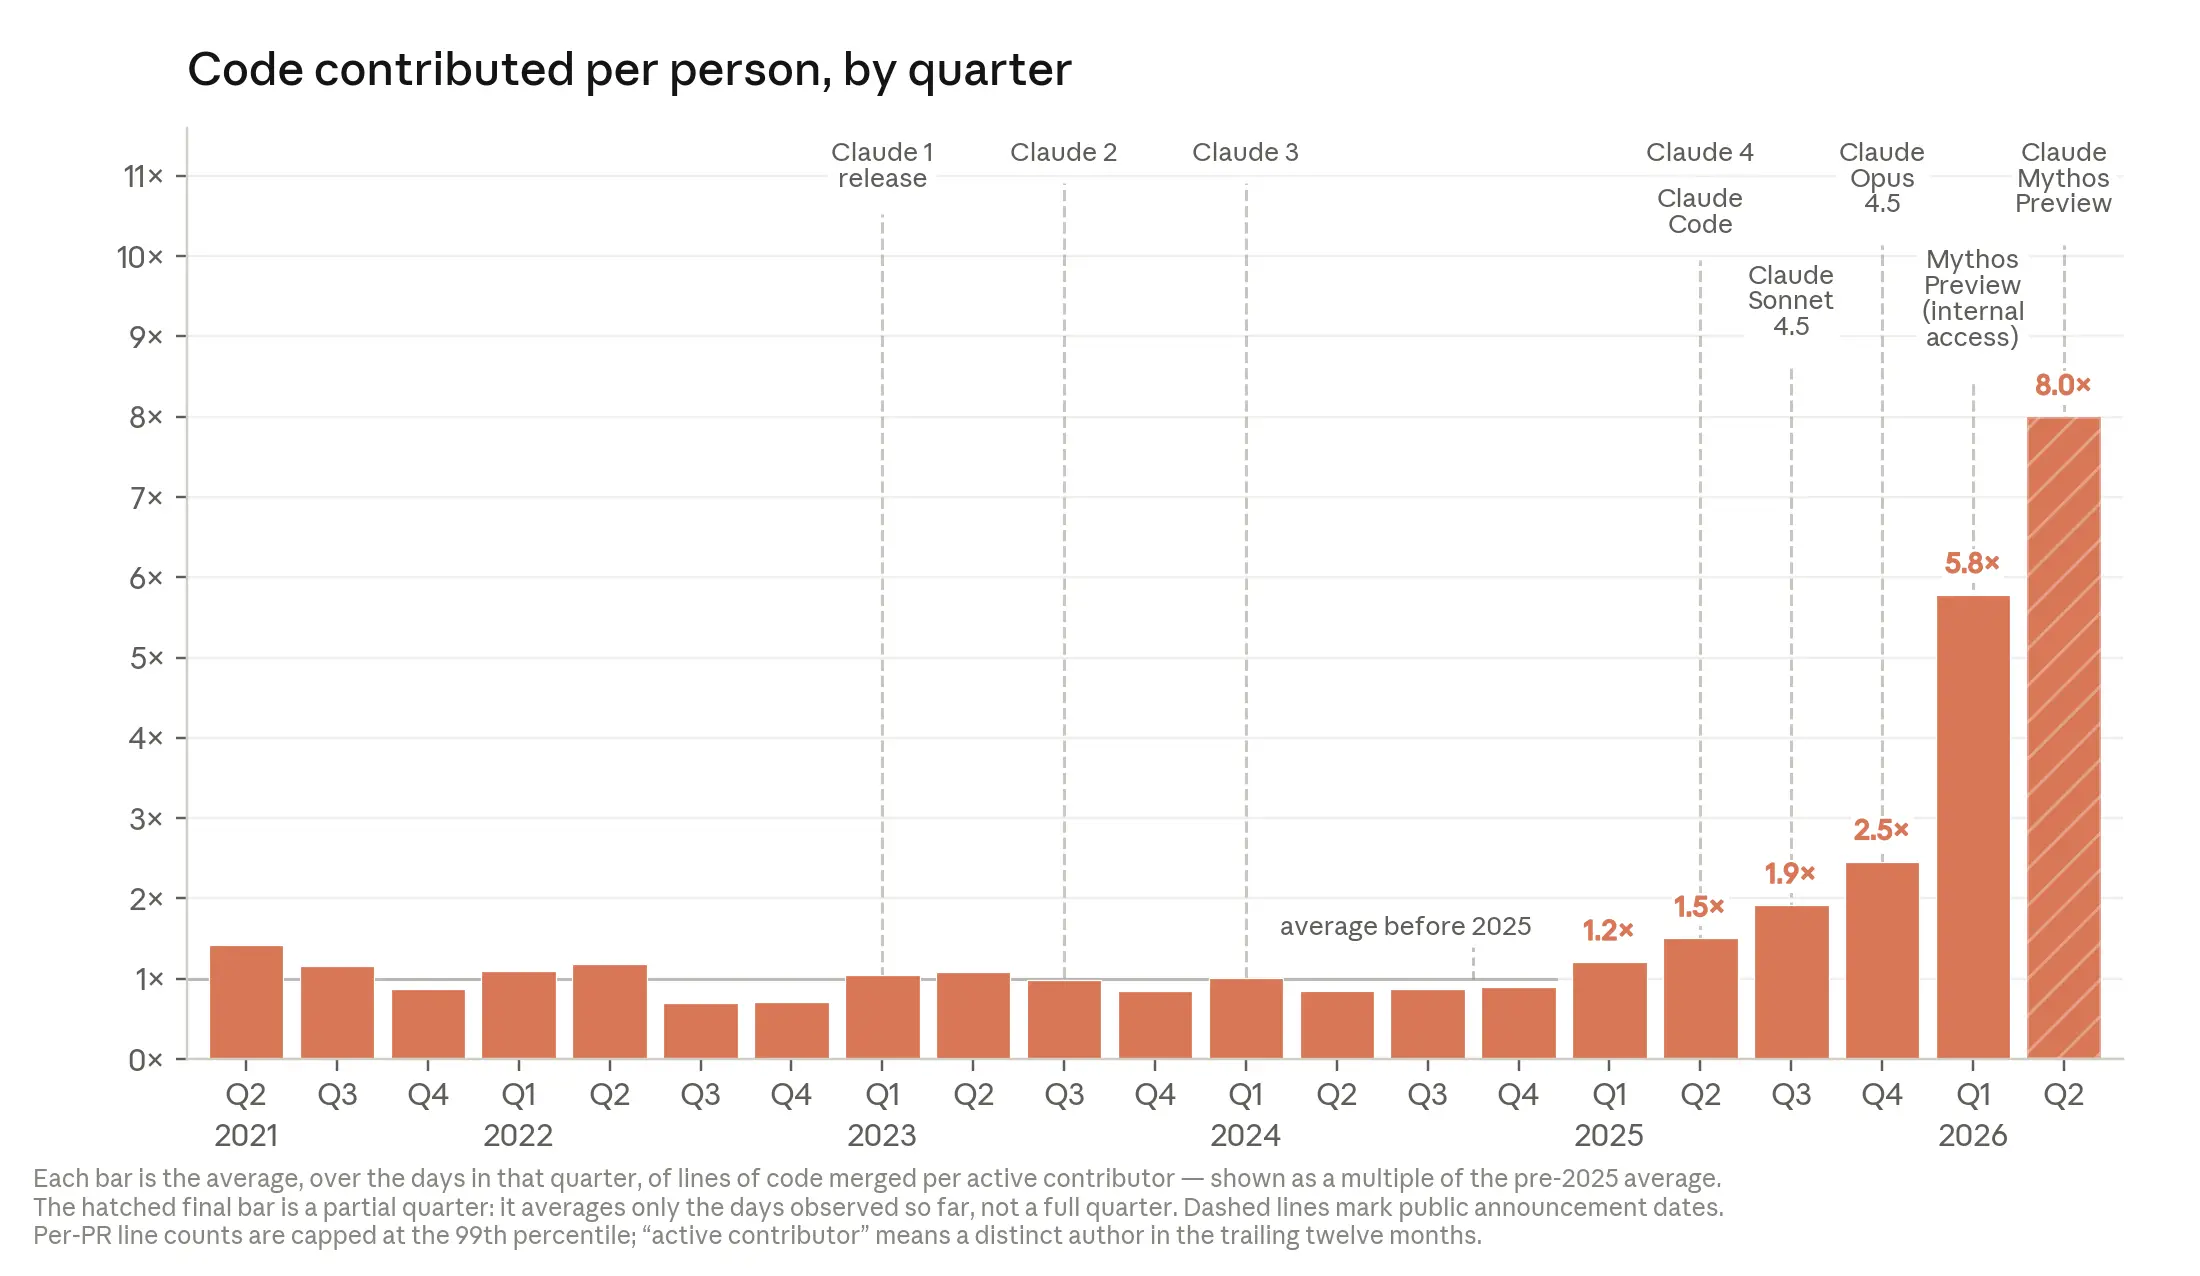
这张图有两个拐点:
- 2025 年初:Claude 开始自己运行代码(而不是让人类复制粘贴),代码量开始上升
- 2026 年:模型开始自主工作更长时间,曲线陡然加速
2026 年 Q2,典型工程师每天合并的代码量是 2024 年的 8 倍。注意,代码行数是不完美的度量——它度量的是数量而非质量。但方向是明确的。
一个更直观的数字:2026 年 3 月,130 名 Anthropic 研究人员的调查显示,中位数受访者估计使用 Mythos Preview 后产出约为不使用 AI 时的 4 倍。
代码质量已接近人类水平
代码质量有两个维度:能用 和 可维护。
在"能用"这个维度上,证据已经非常清楚。Anthropic 员工纠正、重定向或接管 Claude 的频率持续下降——包括最复杂、最开放的任务。
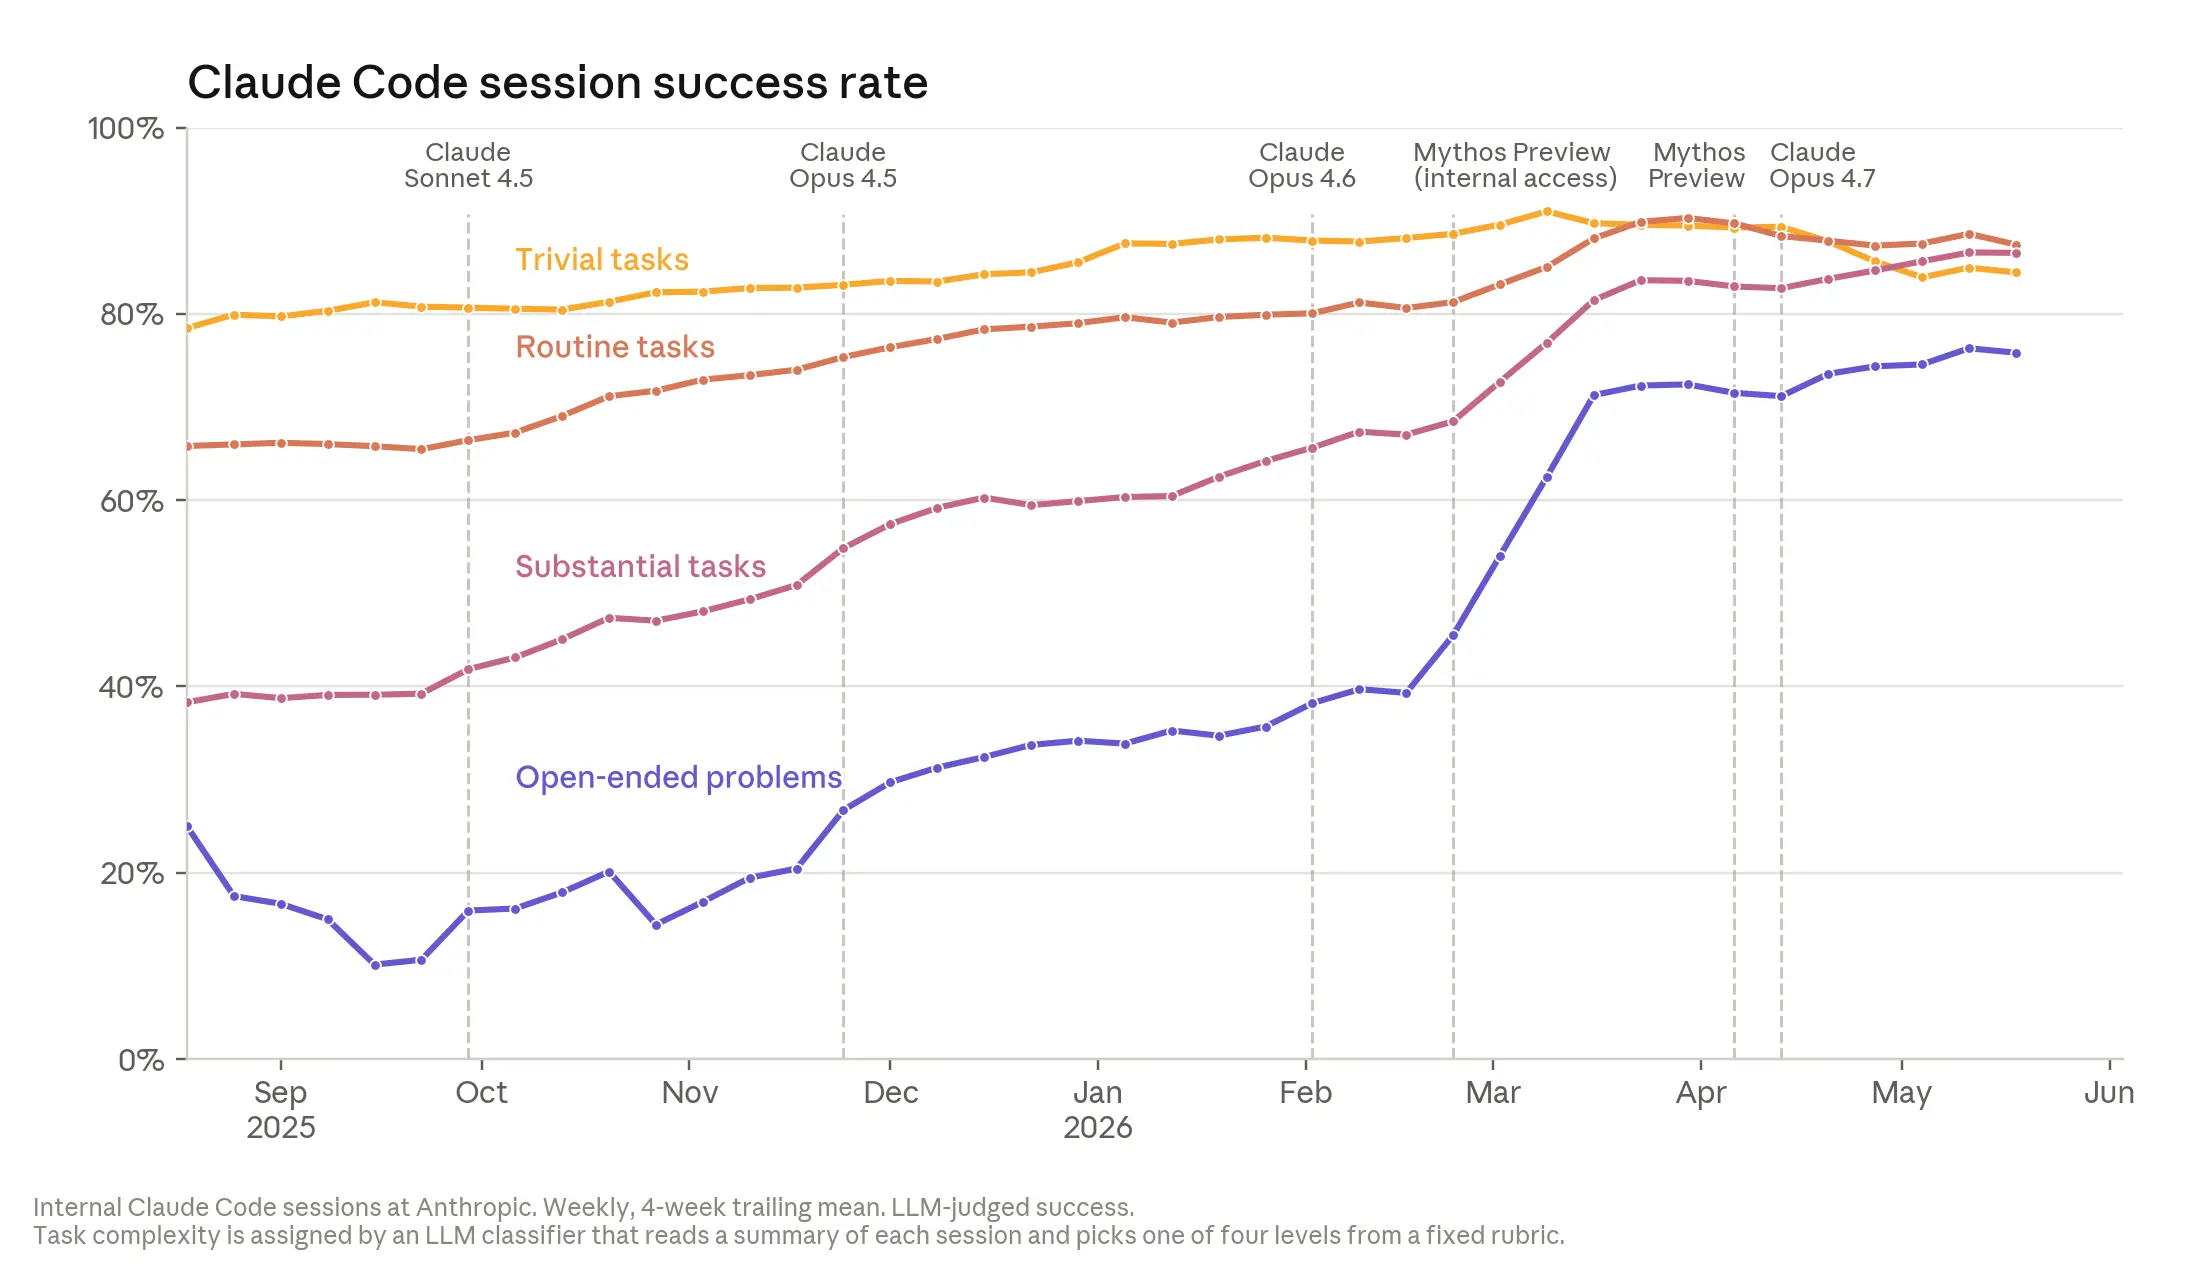
在开放性任务上,Claude 的成功率在 2026 年 5 月达到 76%,六个月内提升了 50 个百分点。
一个具体的例子:一次常规升级导致数万个训练任务崩溃。工程师把现场信息丢给 Claude,Claude 在大约两小时内隔离了一个冷门的调试 flag,可靠地复现了问题并确认了修复。这通常是两到三天的工作量。
在"可维护"这个维度上,差距在快速收窄。Anthropic 内部普遍认为:Claude 写的代码在 2025 年底还不如人类,目前已经基本持平,预计年内将超过人类水平。
一个有趣的发现:Anthropic 用 Claude 自动审查代码变更,回溯分析发现,如果一直用 Claude 审查,它能在大约三分之一的 bug 进入生产环境之前就发现它们。而写出那些代码的工程师,是世界上构建这类系统最顶尖的一批人。
实验优化:从超有用到超人类
Anthropic 每次发模型都跑一个固定测试:给 Claude 一段训练小型 AI 模型的代码,让它尽可能加速同时保持正确性。
- 2025 年 5 月,Claude Opus 4:约 3x 加速
- 2026 年 4 月,Claude Mythos Preview:约 52x 加速
- 对比:一个熟练的人类研究员需要 4–8 小时才能达到 4x
在明确目标下的实验执行这个环节,Claude 在不到一年内从"超有用"变成了"超人类"。
研究判断力:最后的差距
但实验执行和实验设计是两回事。Anthropic 做了一个实验来衡量这个差距:
他们找了 129 个真实的研究会话,这些会话都有一个共同特点——研究员在某个时刻走了一个弯路。他们把这个弯路之前的内容截断,问各个 Claude 模型"你下一步会怎么做",然后用一个能看到完整会话结果的 Claude 来判断:AI 和人类谁的选择更好?
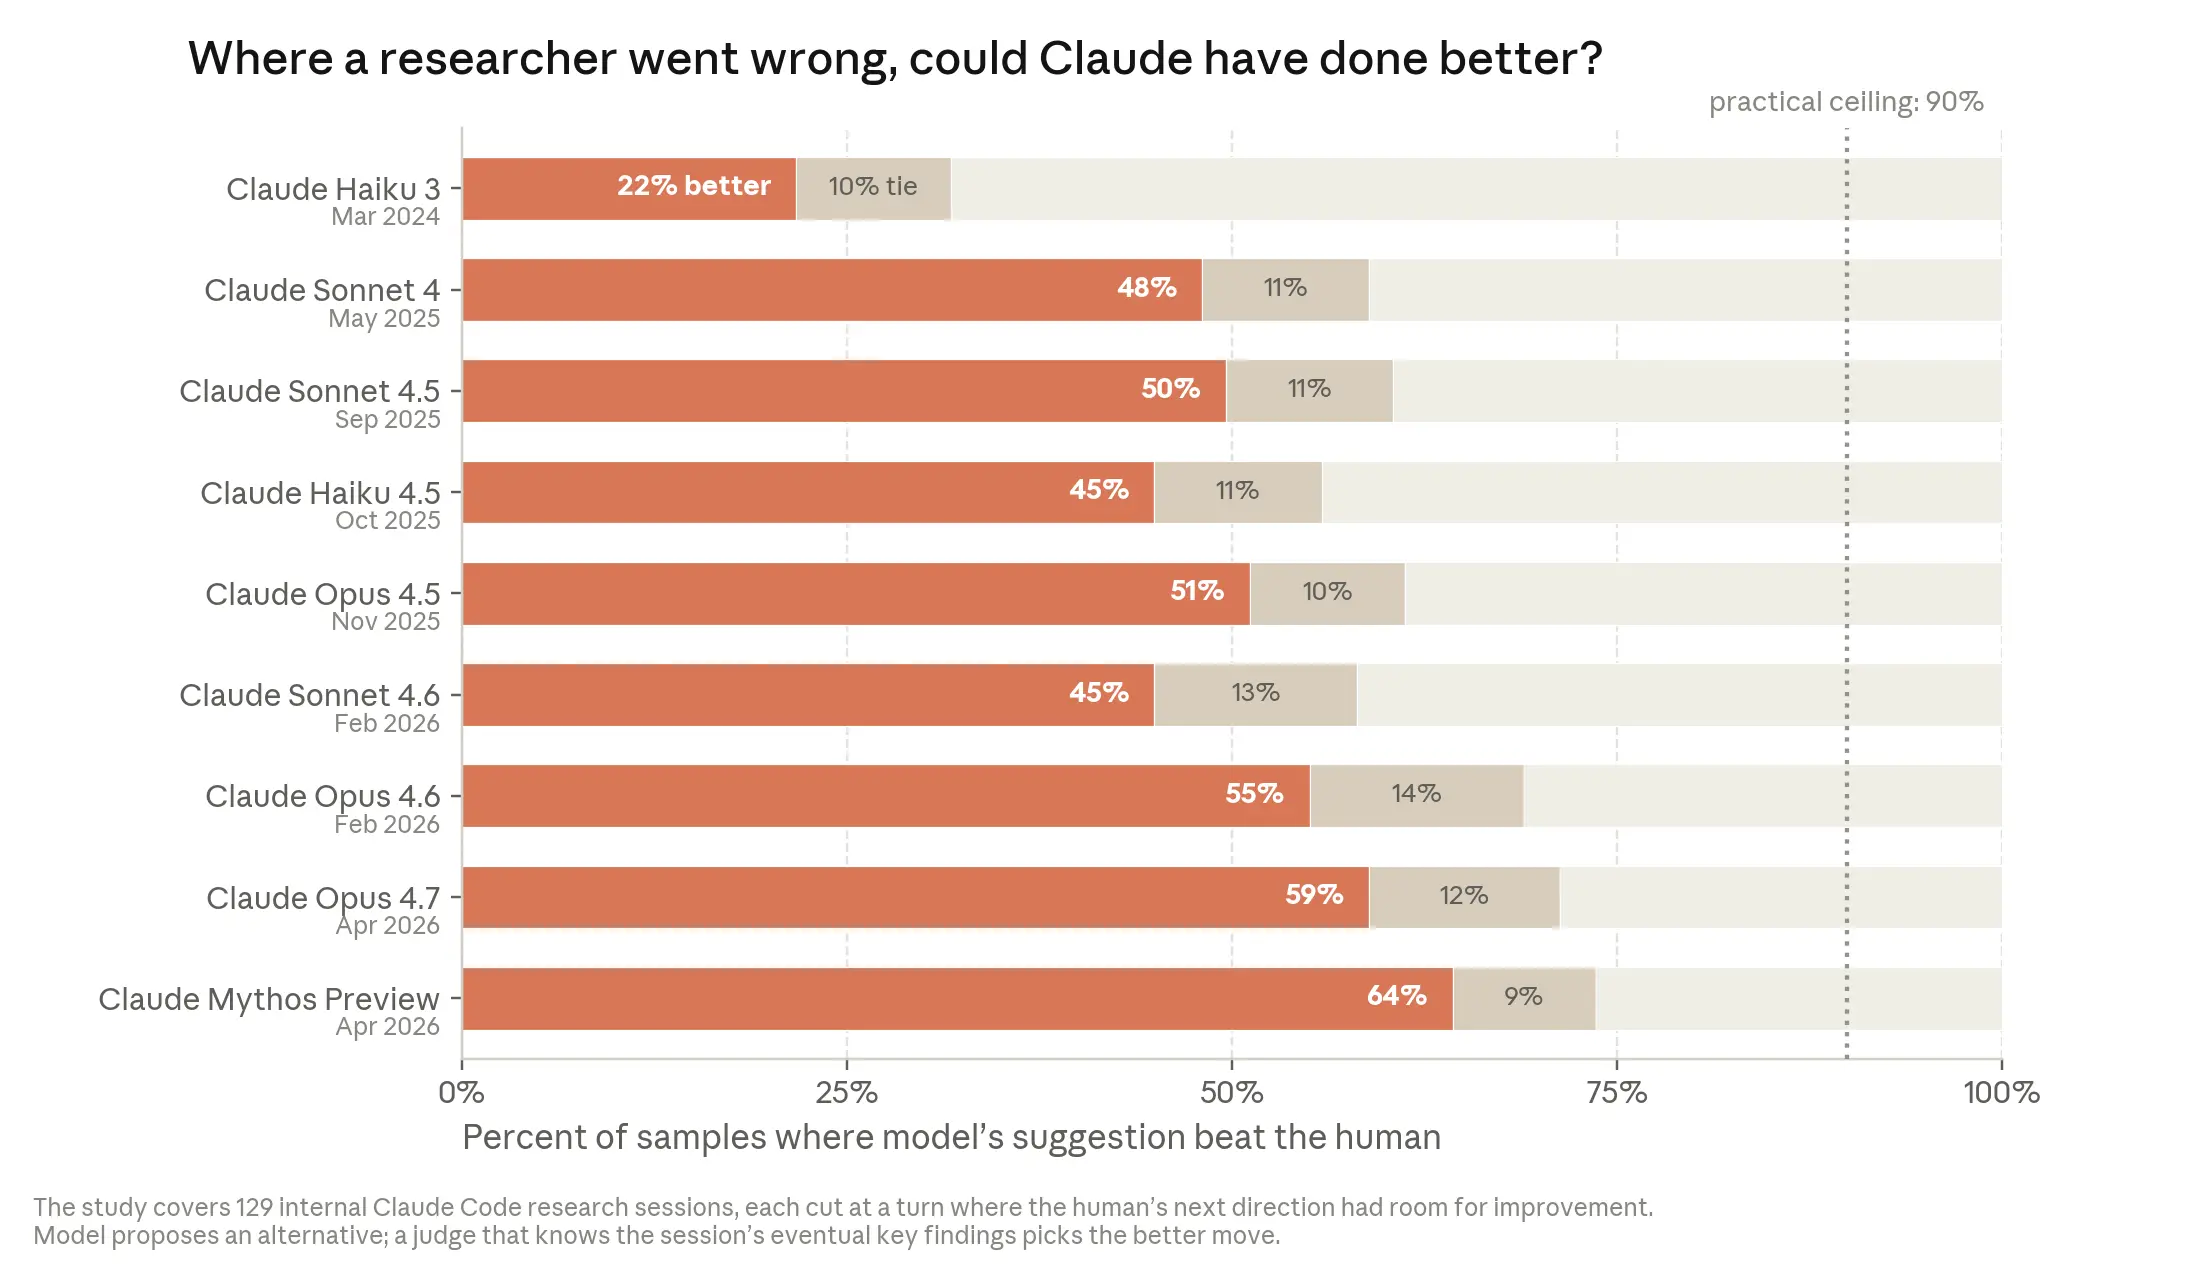
结果:
- 2025 年 11 月,Claude Opus 4.5:51% 的情况下比人类选择更好
- 2026 年 4 月,Claude Mythos Preview:64% 的情况下比人类选择更好
注意,这组数据本身就偏向 AI——因为他们刻意挑选了人类判断有改进空间的时刻。但作为一个衡量 AI 研究判断力随时间提升的指标,方向是清晰的。
这就是 AI 今天和"能自主设计自己继任者"之间的差距:方向设定——选择什么问题值得研究、什么结果值得信任、什么时候该放弃一条路。
三种未来场景
Anthropic 提出了三种可能的未来:
场景一:趋势停滞,但当前能力广泛扩散
指数曲线可能实际上是 S 曲线,我们可能正在接近拐点。"研究品味"可能是一种无法通过扩大训练来获得的能力。或者瓶颈可能在供应链——芯片产能、电网扩张、互联带宽。
即使模型能力冻结在今天的水平,变革仍然巨大。Project Glasswing 项目中,Mythos Preview 在最初几周就发现了全球最重要系统中超过一万个高危软件漏洞。一个 100 人的公司将能完成过去 1000 人的工作。
Anthropic 认为这个场景可能性最低——因为他们观察到每一个可衡量的能力指标都在同一条上升曲线上,还没有看到曲线变平的迹象。
场景二:AI 实验室持续获得复合效率增益
AI 开发被大幅自动化,但人类继续设定研究方向。100 人的公司能做 10,000 甚至 100,000 人组织的工作。
但这里有 Amdahl 定律的影子:加速一部分流程只会把瓶颈推到其他地方。Anthropic 已经遇到了这个问题——随着代码量暴增,人类的代码审查成了新的瓶颈。同样,新想法、新工具、新模拟的爆炸式增长远远超出了他们能追求的范围。
识别和修复瓶颈的能力,可能成为任何组织最重要的能力。
场景三:AI 系统实现完全的递归自我改进
AI 开始设计和精炼自身。进步的速度完全由算力可用性决定。人类角色大幅缩减,主要转向监督、验证和确认一个不断扩展的"虚拟实验室"。
这个场景最不确定的部分是对齐问题:
- 模型可能足够对齐且有足够的研究品味,发现并实施人类尚未达到的新方案
- 也可能够聪明到在不确定时主动暂停开发
- 但也可能——今天模型中罕见的不对齐行为在构建继任者时复合增长,变得越来越频繁却越来越不被理解,直到人类失去控制
Anthropic 的立场:我们需要暂停的选项
文章最后提出了一个明确的政策立场:
如果有可能有效地减缓这项技术的发展,给我们更多时间来处理其巨大影响,我们认为这可能是好事。但如果减速只是让最不谨慎的参与者在技术上赶上来,可能会让每个人都更不安全。
Anthropic 明确表示:如果其他前沿开发者也能以可验证的方式减速或暂停,他们愿意这样做。
但实现可信的暂停极其困难:
- 训练运行比导弹发射井更容易隐藏
- 训练的输入是通用资源(算力、电力)
- 悄悄违约的激励巨大——谁在别人暂停时继续,谁就能继承领先地位
- 暂停还需要定义触发条件、解除条件和裁决机制
Anthropic 承诺在未来几个月组织政策制定者、研究人员、公民社会和其他 AI 公司的对话,推动这些问题——特别是围绕完全递归自我改进和如何创建更好的协调选项。
我的思考
几点个人观察:
1. "8 倍代码量"是一个被低估的数字。 因为这不只是"写了更多代码"——它改变了工程师的角色定义。工程师从"写代码的人"变成了"审查和引导 AI 的人"。当审查速度跟不上生成速度时(Amdahl 定律),整个流程会再次重组。
2. 研究判断力的进步是最值得关注的指标。 代码编写和实验执行已经接近或超过人类水平,但"决定研究什么"这个最后的人类堡垒正在缩小——从 51% 到 64% 的胜率提升只用了五个月。如果这个趋势持续,"研究品味"可能也只是另一种 AI 能力——AI 会失败一段时间,然后突然变好。
3. 三种场景的分布比结论更重要。 Anthropic 明确说他们认为场景一最不可能。但他们没有押注场景二还是场景三——这本身就是一种信号。如果他们确信递归自我改进不会发生,他们会说"我们距离场景三还很远"。他们没有这么说。
4. 暂停的悖论。 Anthropic 愿意暂停的前提是"其他人也暂停"。但在一个没有全球协调机制的世界里,这几乎等同于"我们不暂停"。这不是批评——这是一个真实的囚徒困境。文章在这一点上非常诚实。
5. 最被低估的风险:不是 AI 变得强大,而是人类的协作基础设施被侵蚀。 文章引用了一位 Anthropic 员工的话让我印象深刻:
工作和生活曾经运行在人与人之间的小恩小惠的礼物经济上。"你能帮我跑一下这个脚本吗?"……每一个请求都创造了一点人情债、一点相互认知。Claude 更快,不产生人情债,但每一个这样的请求都是一次人类协作机会的丧失。
当 AI 让每个请求都能被即时满足时,人与人之间的协作纽带也在被悄无声息地削弱。这不是技术问题,而是社会结构问题。
原文核心数据速查
| 指标 | 数值 |
|---|---|
| Claude 编写的代码占比 | > 80%(2026 年 5 月) |
| 工程师代码产出提升 | 8x(对比 2024 年) |
| 研究员自评产出提升 | ~4x(使用 Mythos Preview) |
| 开放性任务成功率 | 76%(2026 年 5 月,六个月提升 50 个百分点) |
| 实验优化加速 | 从 3x(Opus 4)到 52x(Mythos Preview) |
| 研究判断力超越人类 | 64% 的时刻模型建议优于人类(Mythos Preview) |
| 任务时长翻倍周期 | ~4 个月(从 ~7 个月加速) |
| Claude 一次性修复量 | 800+ 修复将某类 API 错误降低 1000 倍 |
本文基于 Anthropic Institute 2026 年 6 月发布的 When AI builds itself 撰写,包含个人解读和分析。
先说结论:这不是一个「深色主题」博客
很多人做「终端风」,就是在白色博客上换成深色背景加个等宽字体,完了。这个博客不是这样做的。
打开 blog.suchuanyi.dev,你看到的不是一个换了皮的 WordPress。你会看到一个在浏览器里运行的终端 IDE。每一个 UI 元素都有对应的终端隐喻,不是装饰,是交互逻辑本身。
顶部状态栏:你的 tmux pane
导航栏模仿的是 tmux 的 pane 标题行。左边是站点名 terry.so 前面带一个绿色圆点 ●,然后是当前路径:
● terry.so ~/posts/open-source-terminal-blog main*
~/ 后面跟着你当前所在的路径段,最后一截高亮显示——就像你在 tmux 里看到的 pane 标题一样。末尾的 main* 表示当前分支有未提交的改动(当然是假的,但感觉对了)。
右边是状态信息:GitHub Fork 链接、⌘K 命令面板入口,还有一个绿色脉冲圆点配 CONNECTED 字样——你的终端连上了远程服务器那种感觉。
整个导航栏是 sticky 的,磨砂玻璃效果(backdrop-blur),往下滚也不会消失。
底部状态栏:Vim 的 mode line
页面最底部固定了一行状态栏,完全模仿 Vim 的底部 mode 行:
[NORMAL] index.md g home t tags a about ⌘K palette UTF-8 14:32
- 左边是
NORMAL模式标签(绿色高亮),像 Vim 的-- INSERT -- - 旁边是当前文件名,比如
index.md或posts/open-source-terminal-blog.md - 右边是快捷键提示和系统信息:编码(UTF-8)、当前时间(实时更新)
这不是静态装饰。时间每秒刷新,文件名跟随路由切换,NORMAL 标签一直告诉你「你不在输入模式」。
Vim 键位:全程不用鼠标
这是我最喜欢的部分。整个站点的导航可以用 Vim 键位操作:
| 按键 | 动作 |
|---|---|
g |
回首页(连续按两次 gg 跳到第一页) |
t |
标签页 |
a |
关于页 |
⌘K |
命令面板 |
h / ← / [ |
上一页 |
l / → / ] |
下一页 |
G(大写) |
跳到最后一页 |
/ |
聚焦搜索框(Vim 搜索的肌肉记忆) |
ESC |
关闭命令面板 |
在首页翻页的时候,h 和 l 的体验和 Vim 里左右移动光标一模一样。gg 跳回第一页,G 跳到最后一页——完全复刻 Vim 的行首行尾。
搜索框按 / 聚焦,这是 Vim 里搜索的键位。搜索结果出来之后可以 ESC 关掉。整套键盘流可以完全不用鼠标浏览整个博客。
命令面板:终端里的模糊搜索
⌘K 打开命令面板。外观是一个 $ 开头的终端输入框,底下列出可用命令:
$ type a command...
  :home
  :tags
  :about
输入几个字母自动过滤,Enter 执行第一个匹配项,ESC 关闭。和 VS Code 的命令面板一样好用,但长得像你的 shell。
首页:ls 你的文章列表
首页不是传统博客那种大图卡片布局。它更像是在终端里 ls -la 你的文章目录:
$ ls -la ~/articles | sed -n '1,10p'
上面这行是真的渲染在页面上的,作为 banner 的一部分。每个文章条目是一个网格行:
01  文章标题                                UPDATED: 2026-05-30
    文章描述文字...                          SIZE: 12KB
    #tag1  #tag2  #tag3                     READ: 8MIN
左边是序号(两位数,零填充),中间是标题 + 描述 + 标签,右边是文件元信息——就像 ls -la 的输出列。标签用 # 前缀,加了细边框,像终端里的 badge。
右上角显示当前页码和总数:PAGE 01/04 · TOTAL 37,用大写字母和零填充——信息密度拉满,但不会觉得乱。
文章页:YAML frontmatter 直接渲染
打开一篇文章,正文上方不是传统的「作者 + 日期」元信息块。你看到的是一段被渲染的 YAML frontmatter:
---
title:   "文章标题"
date:    2026-06-07
category:[开源, 博客]
tags:    [开源, TanStack Start, pgvector]
status:  published
---
绿色分隔线、等宽字体、键值对网格布局——就像你在终端里 cat 一个 Markdown 文件,frontmatter 原样输出。status: published 用绿色高亮,暗示这篇文章已经 merge 了。
这个设计不是偶然的。写博客的人天天和 frontmatter 打交道,把它直接展示出来,读者一眼就知道「这是一篇 Markdown 文件」,而不是一个 WordPress 页面。
搜索框:长得像 grep
首页的 AI 搜索框不是一个普通的输入框。它长这样:
$ grep -r 问点啥...例如 swift agent 集成 /
左边是绿色的 $ 提示符,紧跟着 grep -r,然后才是输入区域。右边有个 kbd 标签提示按 / 可以聚焦——还是 Vim 的搜索键。
搜索中的状态是 embedding query...,搜索结果标题行显示匹配数:// 3 matches,每条结果前面有相似度百分比。搜索失败的时候是 err: ...。
整个搜索体验就像你在终端里跑了一个命令,然后看着输出一行一行出来。
配色系统:oklch + 语义 token
终端风的灵魂不只是等宽字体,还有配色。
整个博客的颜色系统用 oklch 色彩空间定义,只有六个 token:
| Token | 值 | 用途 |
|---|---|---|
| background | oklch(0.16 0.01 260) |
深蓝黑底 |
| foreground | oklch(0.96 0.005 260) |
接近白色的前景文字 |
| surface | oklch(0.21 0.012 260) |
卡片/面板背景 |
| border | oklch(0.30 0.012 260) |
微妙的分隔线 |
| muted | oklch(0.62 0.01 260) |
次要信息 |
| accent | oklch(0.78 0.18 145) |
终端绿——所有可交互元素的颜色 |
accent 是那个标志性的终端绿,用在链接、提示符、YAML 分隔线、闪烁光标、状态指示灯、快捷键高亮……所有需要「跳出来」的地方。统一、克制、不花哨。
组件层不写任何裸色值。所有颜色都走这六个 token。想换一套配色?改 styles.css 里六行代码,全站跟着变。
选中文字的高亮也是绿色的——::selection 用了 color-mix 把 accent 和透明度混合,选中效果像终端里高亮了一行输出。
闪烁光标:一直在线
页面标题末尾有一个闪烁的下划线 _,用 CSS step-end 动画实现,一秒闪烁一次——和终端里光标的节拍一模一样。
这个光标不是装饰。它在告诉读者「这个页面是活的,你可以输入」。首页标题「Agent 内核深潜」后面跟着 cursor-blink,搜索框打开的时候也是这种节奏。整个站点的交互节奏是统一的。
404 页面:cat: post not found
文章找不到的时候,你看到的不是一个大大的 404 插画。你看到的是:
$ cat: post not found
cd ~/
cd ~/ 是一个可点击的链接,带你回首页。就像你在终端里 cat 了一个不存在的文件,然后 cd 回到 home 目录。
文章内容的排版细节
正文用 sans-serif 字体(Inter),行高 1.75,但标题全部回到等宽字体。这是刻意的设计——结构信息用 mono,阅读内容用 sans。代码块背景比页面底色更深一层(oklch(0.13)),有细边框和圆角,代码高亮用 github-dark 主题。
引用块的左边是绿色竖线,背景有 6% 的绿色透明叠加。分隔线是虚线(dashed),不是实线——像终端里的注释行。
列表的 marker(disc / decimal)全部用 accent 绿色。链接有下划线但透明度 40%,hover 的时候变成实色——微妙但有反馈。
表格强制等宽字体,字号缩小到 0.875rem,表头有 surface 背景。整个表格看起来像终端里的 ps 或 top 输出。
顺便说一下 AI 功能
说了这么多终端风,AI 功能其实是锦上添花。但既然做了,也挺好用:
- TL;DR —— 每篇文章自动生成三句话中文摘要(Gemini Flash)
- 语义相关推荐 —— 文章底部自动推荐 3 篇最相关的旧文(pgvector 余弦相似度)
- 自然语言搜索 —— 首页
grep框输入自然语言,按语义返回结果
三个功能全部通过 Lovable AI Gateway 调用,项目里没有任何 API Key。同步管线用内容哈希做增量闸门,没变过的文章不重算、不花钱。一行脚本触发:./scripts/sync-posts.sh prod。
不想用 AI?VITE_ENABLE_AI=false 一行关掉,退化成纯静态博客。
技术栈一览
| 层 | 选型 |
|---|---|
| 框架 | TanStack Start(React 19、SSR、文件路由) |
| 构建 | Vite 7 |
| 样式 | Tailwind v4 + shadcn/ui,oklch 色彩 token |
| 后端 | Supabase(Postgres + pgvector + RLS) |
| AI | Lovable AI Gateway(Gemini embedding + Flash 摘要) |
| 部署 | Cloudflare Workers |
| 内容 | Markdown,gray-matter 解析 |
首屏 < 100KB,SSR 输出,每个路由都有 canonical / OG / JSON-LD。
Fork 指南
如果你想基于这个博客做自己的:
- Fork 仓库 → github.com/terryso/hack-buffer/fork
- 在 Lovable 导入 → 自动拿到 Supabase 项目和 AI Gateway
- 替换
content/posts/→ 放你自己的 Markdown(frontmatter:title / date / description / tags) - 改品牌 →
__root.tsx(站点信息)、about.tsx(自我介绍)、SiteShell.tsx(站名和导航)、styles.css(配色 token) - 改同步脚本 →
scripts/sync-posts.sh换成你的域名 - 部署 + 同步 → Publish 之后跑
./scripts/sync-posts.sh prod
终端风的 UI 和 Vim 键位不需要任何后端依赖。即使你完全不用 AI 功能,这套终端交互体验也是开箱即用的。
最后
这个博客最大的亮点不是 AI,不是 RAG,不是增量同步。是你打开它的那一刻,感觉像在终端里读文章。顶部路径栏、底部模式行、Vim 键位、grep 搜索框、YAML frontmatter 渲染、闪烁光标——整套 UI 都在说同一件事:这里属于程序员。
AI 是工具,终端是审美,开源是态度。
仓库在这里:github.com/terryso/hack-buffer
有问题开 Issue,或者直接在博客上按 / 搜——毕竟它自己就能搜。

/bmad-spec 提炼意图合约,
/bmad-ux 拆分视觉与行为脊柱,
/bmad-investigate 用工程化取证方式解决复杂问题。
完整更新日志: https://www.bmadcode.com/bmad-update-may-2026-web-bundles-prd-brief-platforms/

想深入了解, 可以阅读下面关于Hermes自进化的系列文章: 从 Memory、Skill 到 Background Review,完整拆解 Hermes 的自进化架构。
https://blog.suchuanyi.dev/posts/hermes-self-evolution-1-overview
如果你已经习惯通过 BAMD 写代码,接下来真正耗时间的,往往不是“写”,而是“协调”。
一个 Epic 里有 5 个、10 个、20 个 Story。每个 Story 都要经历创建规格、开发实现、自动化测试、代码审查、回顾总结。真正让人疲惫的,不是某一步本身,而是你要不断盯着流程、切换会话、处理失败、决定下一步。
Story Automator 想解决的,就是这层“人肉编排”。
昨晚我实际跑了一遍 /bmad-story-automator 的完整流程。下面就是这次使用过程的记录,以及一些当时截下来的图。
它解决的不是“写代码”,而是“盯流程”
先用一句话概括 Story Automator:
你告诉它要处理哪些 Story、用什么执行策略,它就自动完成「创建规格 → 开发实现 → 测试自动化 → 代码审查 → 回顾」这条流水线,只在真的需要人类决策时才打断你。
这和普通“单命令跑一个 Skill”不一样。它更像一个构建周期编排器:
初始化
  → 读取 Epic / Sprint 状态
  → 选择 Story 范围
  → 评估复杂度
  → 选择 Agent 策略
  → 执行 create / dev / automate / review / retro
  → 在失败或冲突时升级给人类
从设计上说,它是在自动化“协调工作”,而不是直接替代某一个具体开发步骤。
升级BMAD到最新版(v6.6)
如果你想体验 Story Automator,需要先把 BMAD 升到 6.6。安装时记得把 BMad Automator (Experimental) 这个模块勾上。
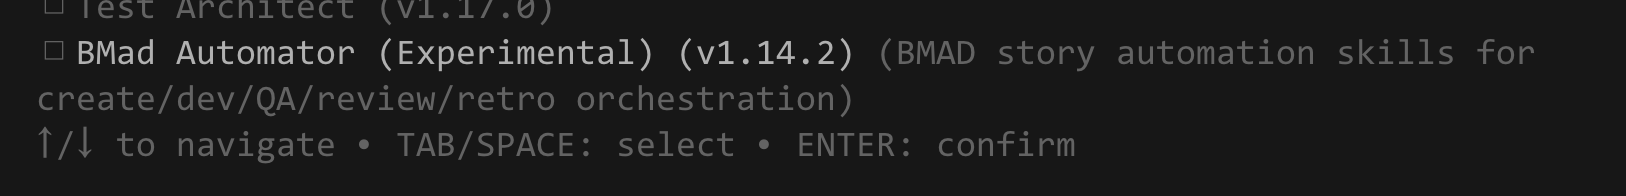
不然装完 BMAD,后面是用不起来的。
第一次运行:先补齐 Stop Hook,防止工作流半路被打断
第一次执行 /bmad-story-automator 时,它不会急着开跑,而是先做初始化检查。
从下面这张图可以看到,它先加载配置,然后尝试读取当前编排状态;如果发现状态目录还不存在,这是正常的首次运行场景。接着它会自动安装 Stop Hook 到 .claude/settings.json 中。
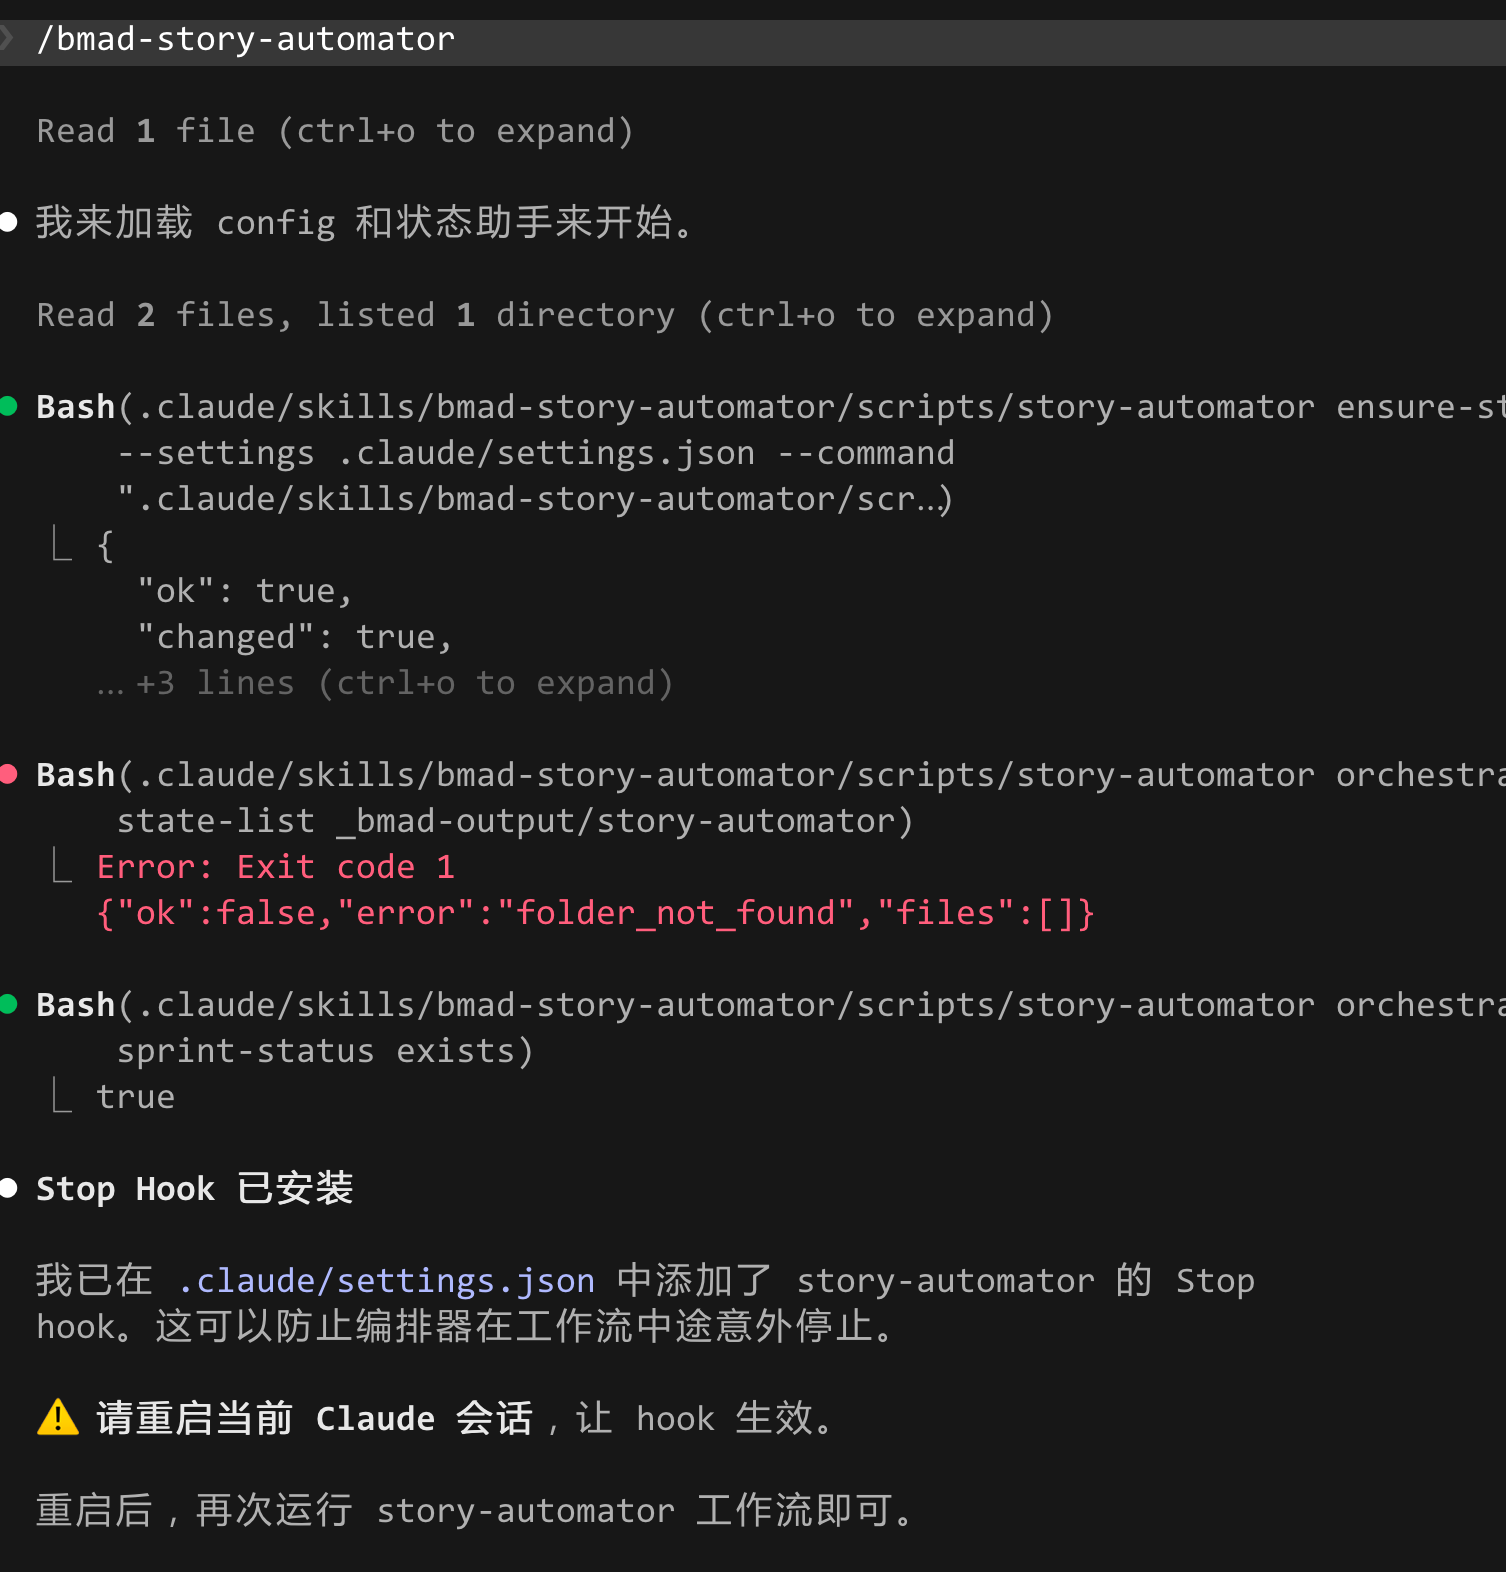
第一步:先选 Story,不是盲跑所有待办项
真正进入编排前,Story Automator 会先读取 Epic 和 sprint 状态,然后让你决定处理范围。
下面这张图展示了一个很典型的场景:Epic 5、6、7 中一部分 Story 已完成,一部分仍然待办。工具会把这些状态直接展示出来,然后询问你要处理哪些 Story。
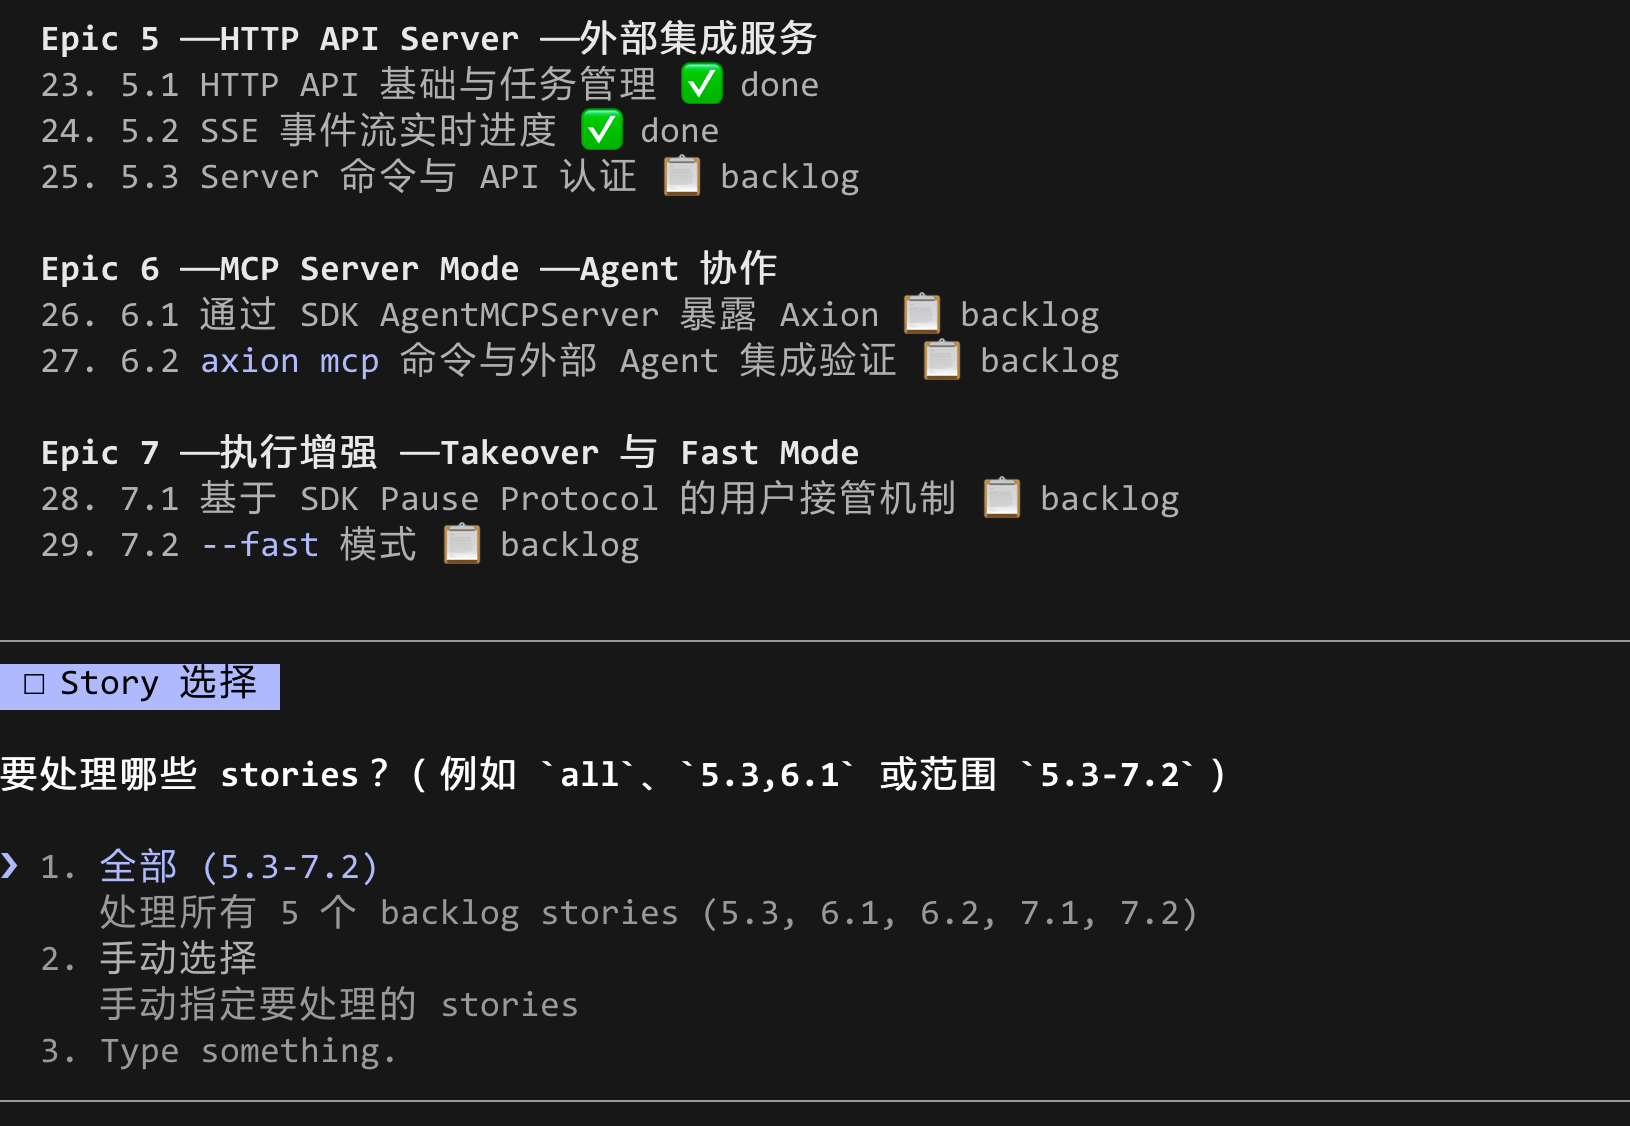
第二步:复杂度不是拍脑袋,而是先打分再分配 Agent
这是我觉得 Story Automator 最有意思的部分之一。
它不是把所有 Story 一股脑丢给同一个 Agent,而是先生成一个Story 复杂度矩阵。截图里可以看到:
- Story 5.3 “Server 命令与 API 认证” → 4 分 / Medium
- Story 6.1 “通过 SDK AgentMCPServer 暴露 Axion” → 2 分 / Low
- Story 6.2 “axion mcp 命令与外部 Agent 集成验证” → 2 分 / Low
- Story 7.1 “基于 SDK Pause Protocol 的用户接管机制” → 2 分 / Low
- Story 7.2 “--fast 模式” → 5 分 / Medium
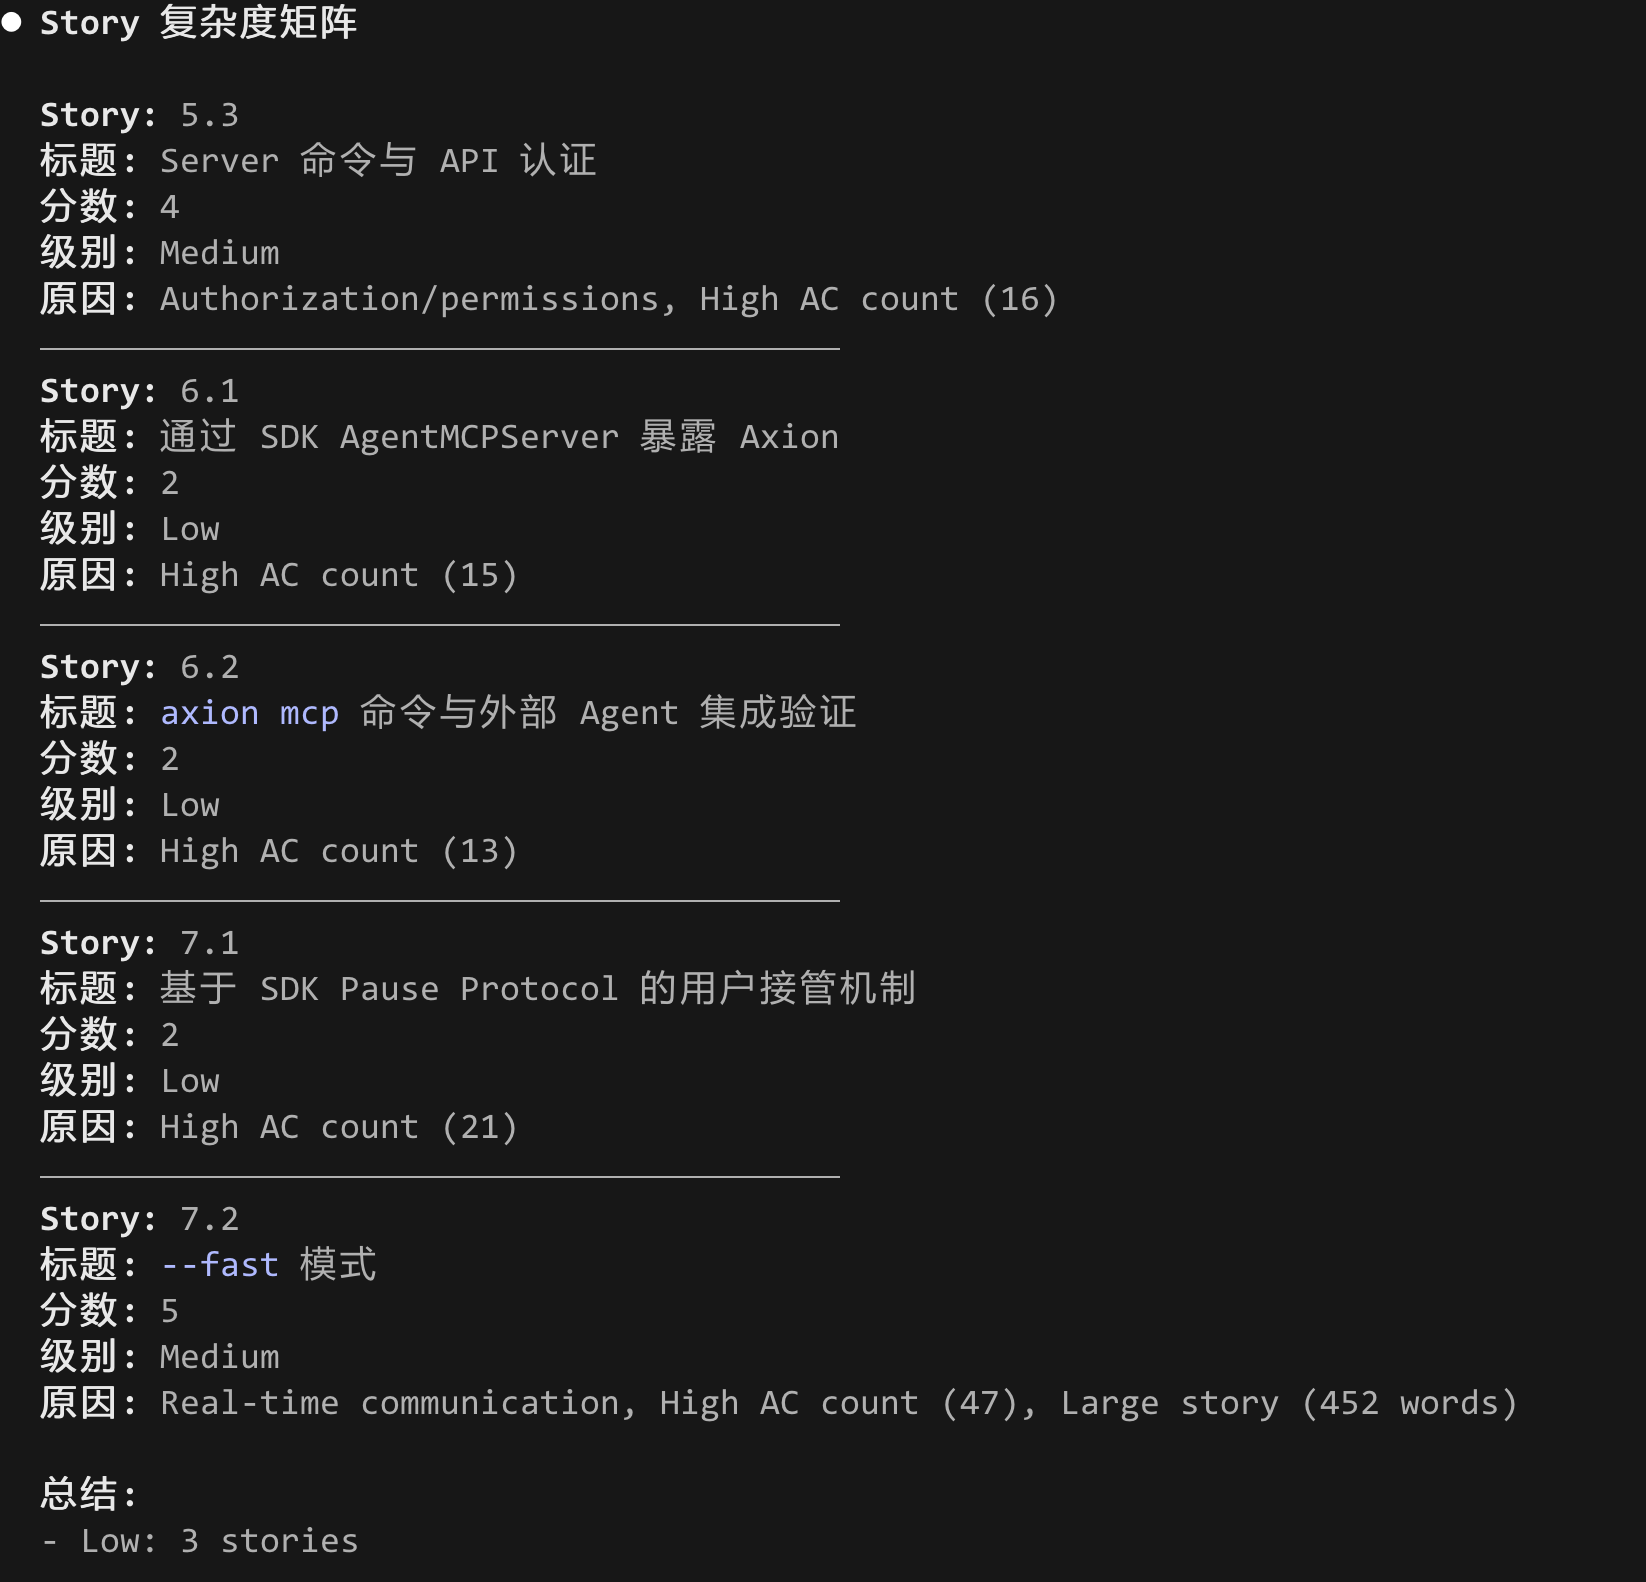
更关键的是,它不只给分,还给出原因:
- authorization / permissions
- 实时通信
- 验收标准数量高
- Story 文本较大
这意味着复杂度评估不是黑盒。你看到的不只是“结论”,而是“为什么它觉得这个 Story 更难”。这会直接影响后续的 Agent 选择策略。
换句话说,Story Automator 在做的事其实是:
先把 Story 变成“可调度对象”,再决定谁来执行。
第三步:你可以塞入自定义指令,但默认不强迫你多想
接下来它会问你有没有自定义指令。
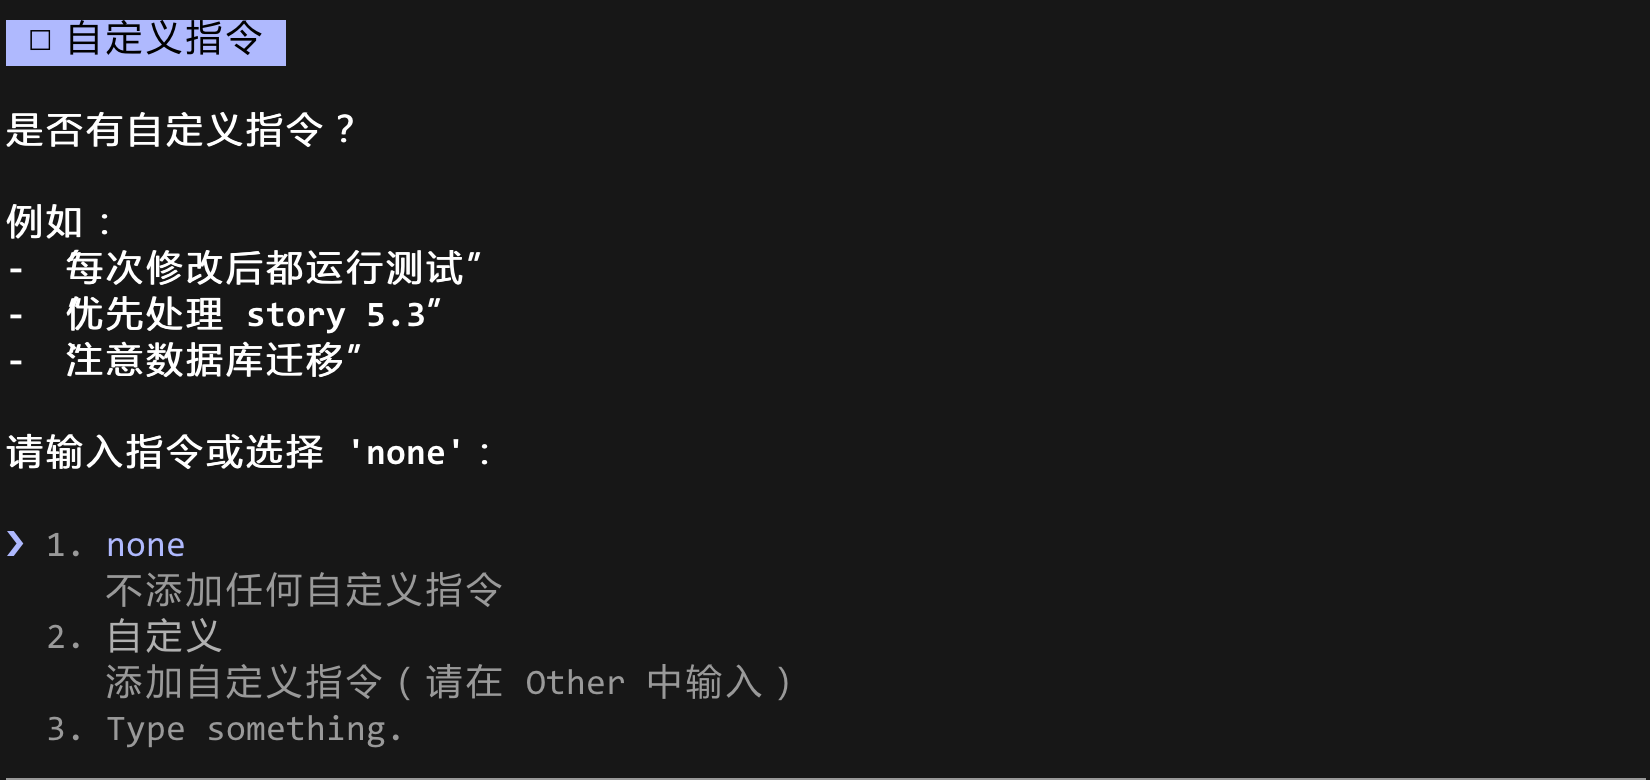
比如:
- 每次修改后都运行测试
- 优先处理某个 Story
- 注意数据库迁移
这个设计我很喜欢,因为它在“全自动”和“可控”之间找到了一个不错的平衡:
- 如果你没有特殊要求,直接选
none - 如果你有本轮迭代的偏好,可以临时注入
也就是说,它把“人类经验”当成一种可选输入,而不是每次都强迫你从头配置一大堆参数。
第四步:执行设置决定它跑得多激进
再往下,就是执行策略层面的配置。截图中可以看到两个核心问题:
- 是否跳过
automate步骤(测试自动化) - 最大并行会话数是多少
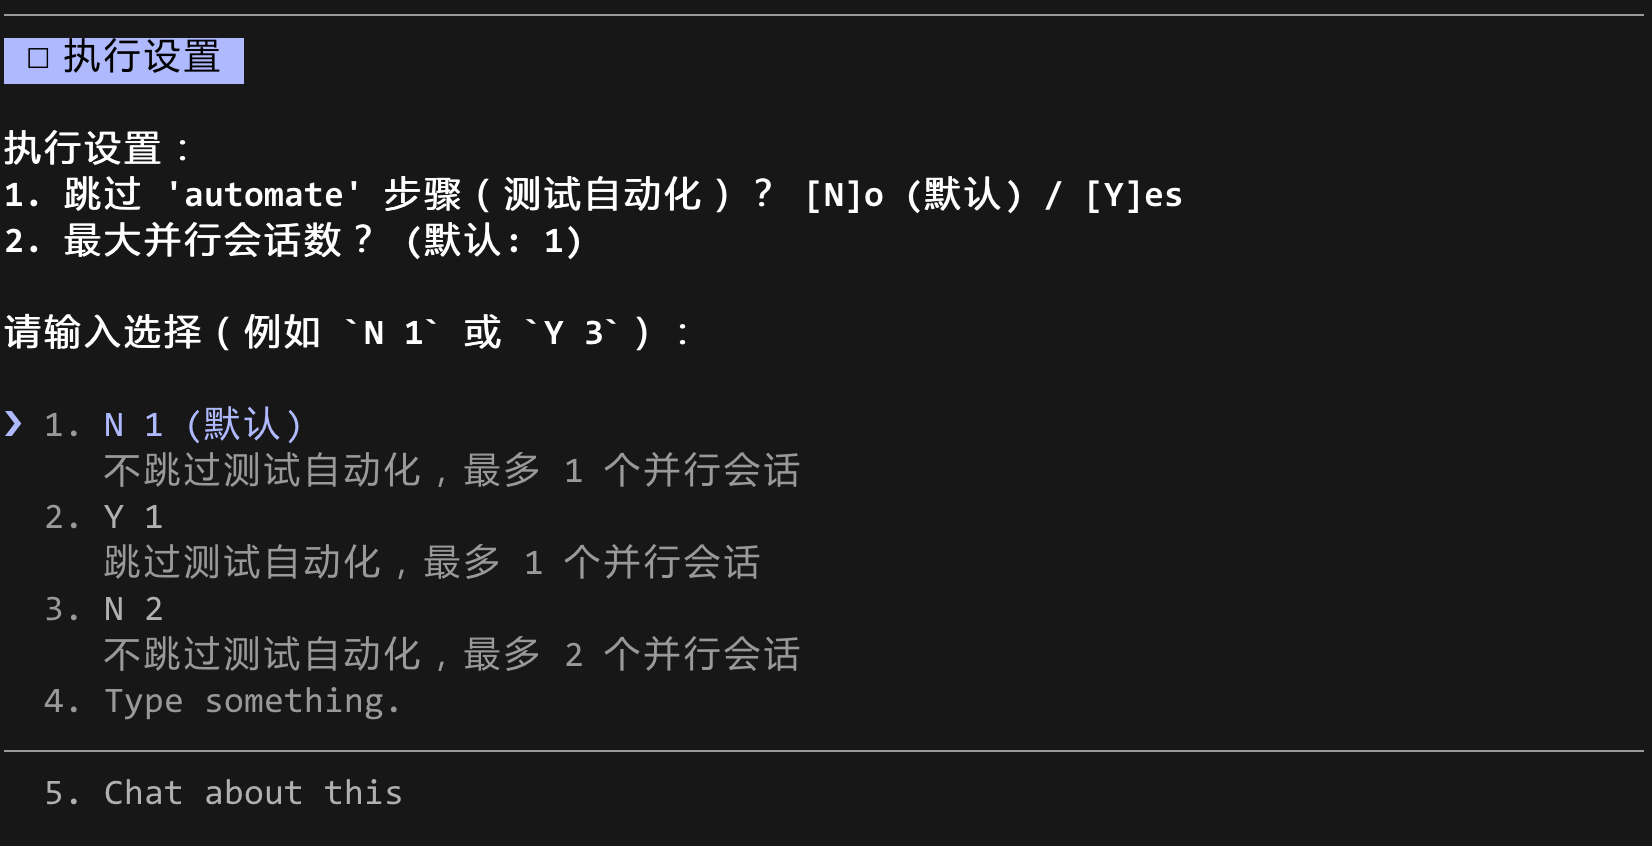
默认值是:
- 不跳过 automate
- 最多 1 个并行会话
对大多数真实项目来说,测试自动化是交付闭环里最不该轻易跳过的一环;而并行度默认设为 1,也避免了多个会话同时改动同一代码库时互相干扰。也就是说:
默认先追求“可控完成”,而不是“并行冲刺到极限”。
第五步:不同复杂度,自动映射到不同 Agent
有了复杂度矩阵之后,Story Automator 就能推荐 Agent 配置。
推荐配置如下:
- Low:create / dev / auto / review 都用 Claude
- Medium:create / dev / auto / review 都用 Codex,Claude 作为备选
- High:同样以 Codex 为主
- Retro:回顾阶段使用 Claude
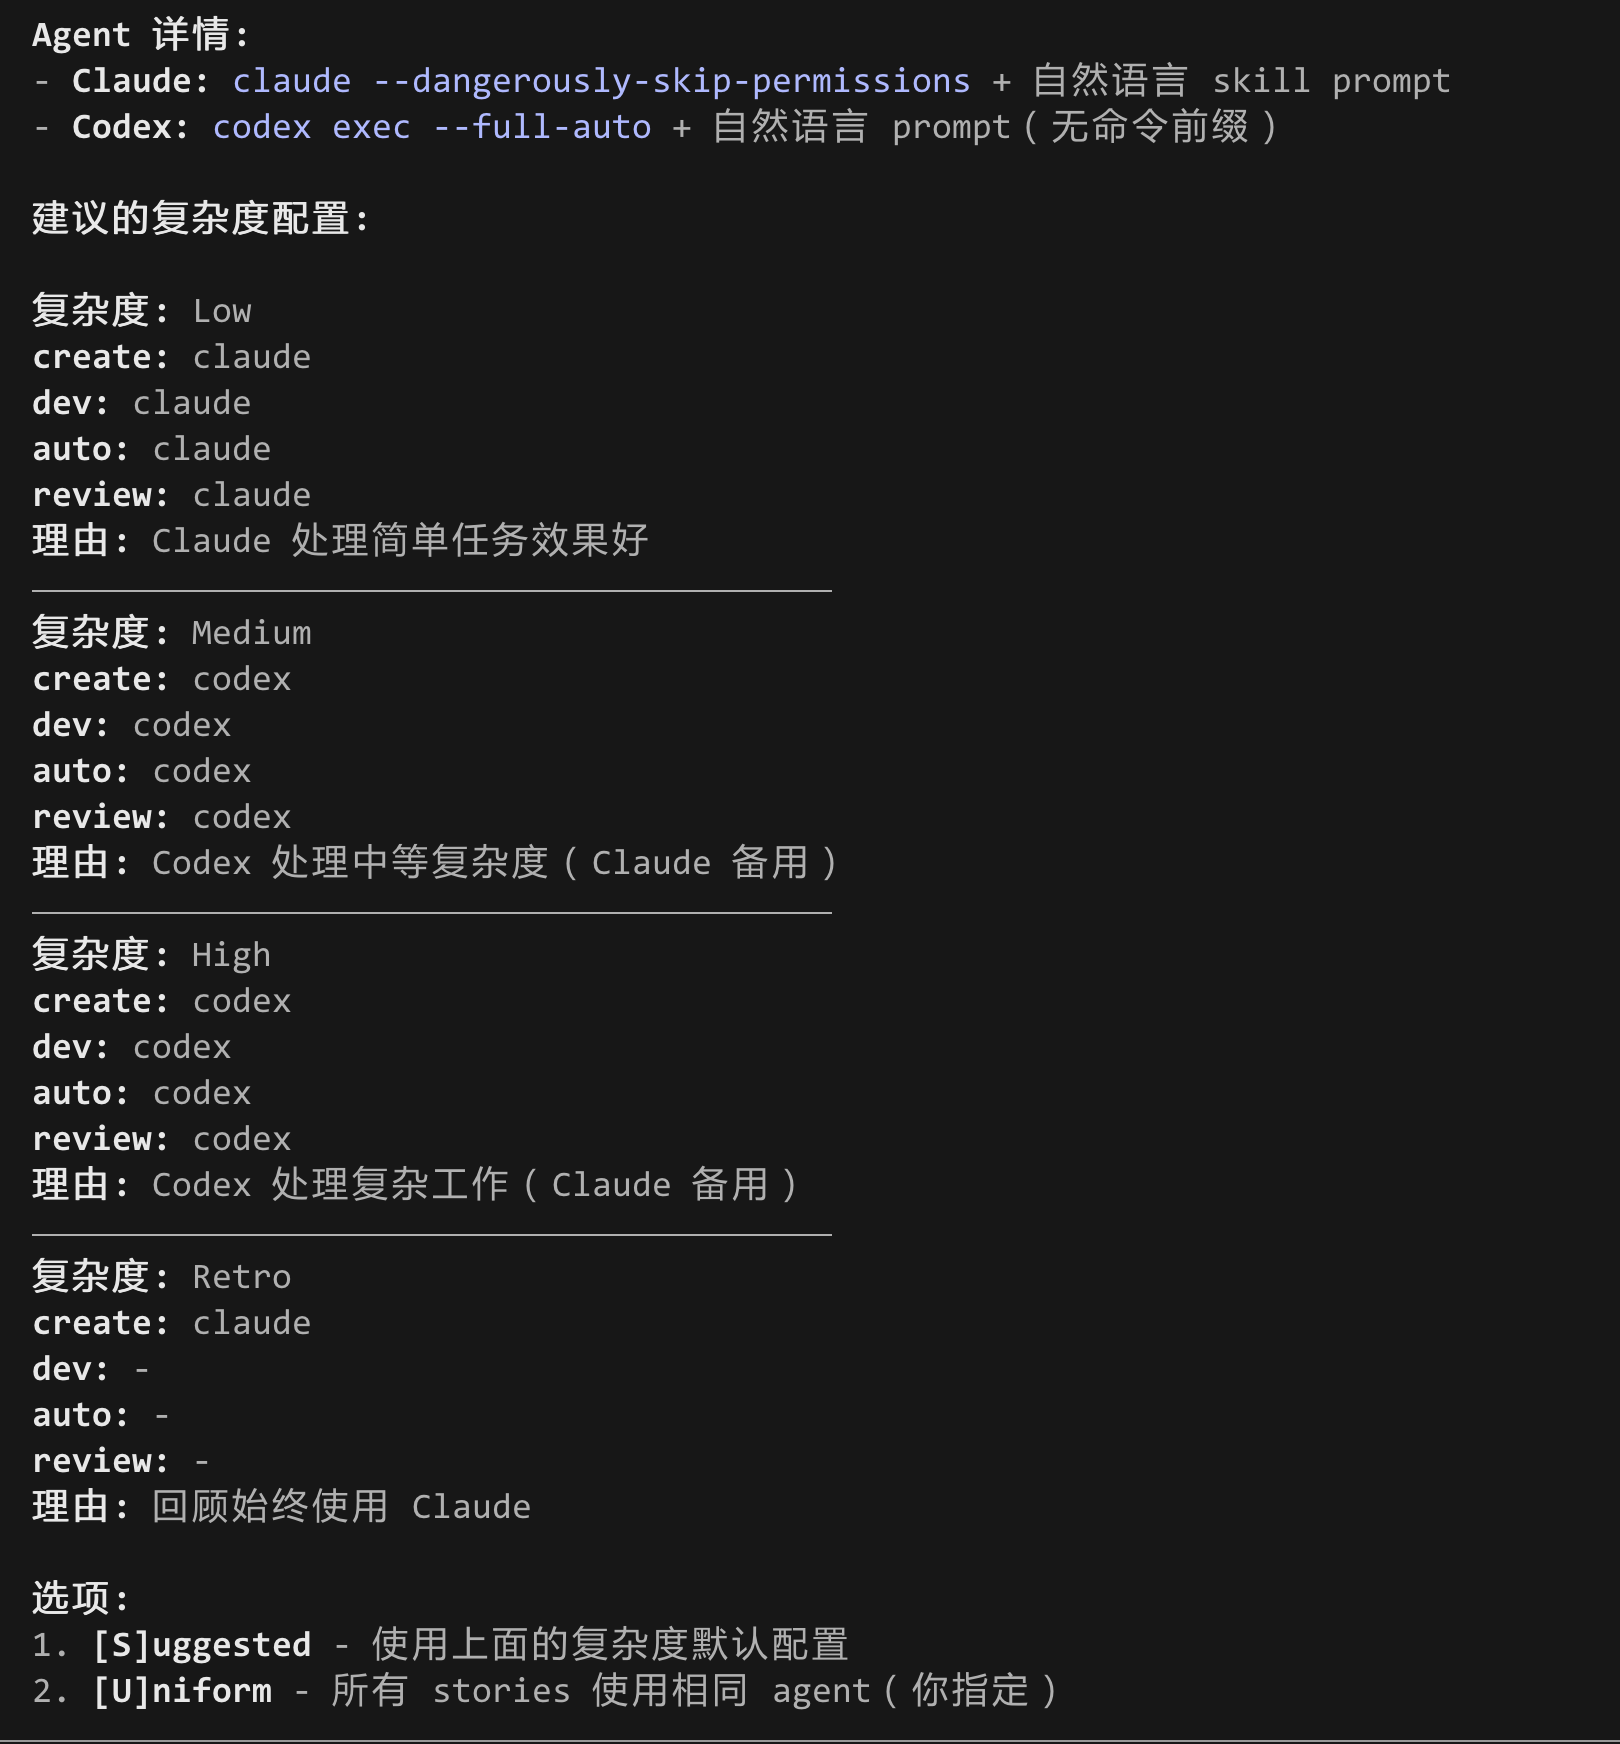
从这个配置可以看出,它已经不是“调用一个模型”的层面了,而是在做模型编排。
而且它还提供了策略选项:
- Suggested:采用按复杂度分层的推荐配置
- Uniform:所有 Story 都使用同一个 Agent
不同团队可以这样用:
- 想稳一点,按推荐走
- 想保持行为一致,就统一 Agent
而从后面的配置摘要截图也能看出来,这次实际演示最后保存成了 all-claude。这恰好说明:推荐是推荐,不是强制。 你既可以让系统按复杂度智能分配,也可以为了稳定性或一致性,手动统一到同一类 Agent。
这一步让整个系统更像一个“调度器”,而不是一个简单的命令包装器。
第六步:配置会被显式保存,方便恢复和复盘
当你确认后,Story Automator 会把这次运行配置保存下来。截图里展示的是一个名为 all-claude 的配置摘要:
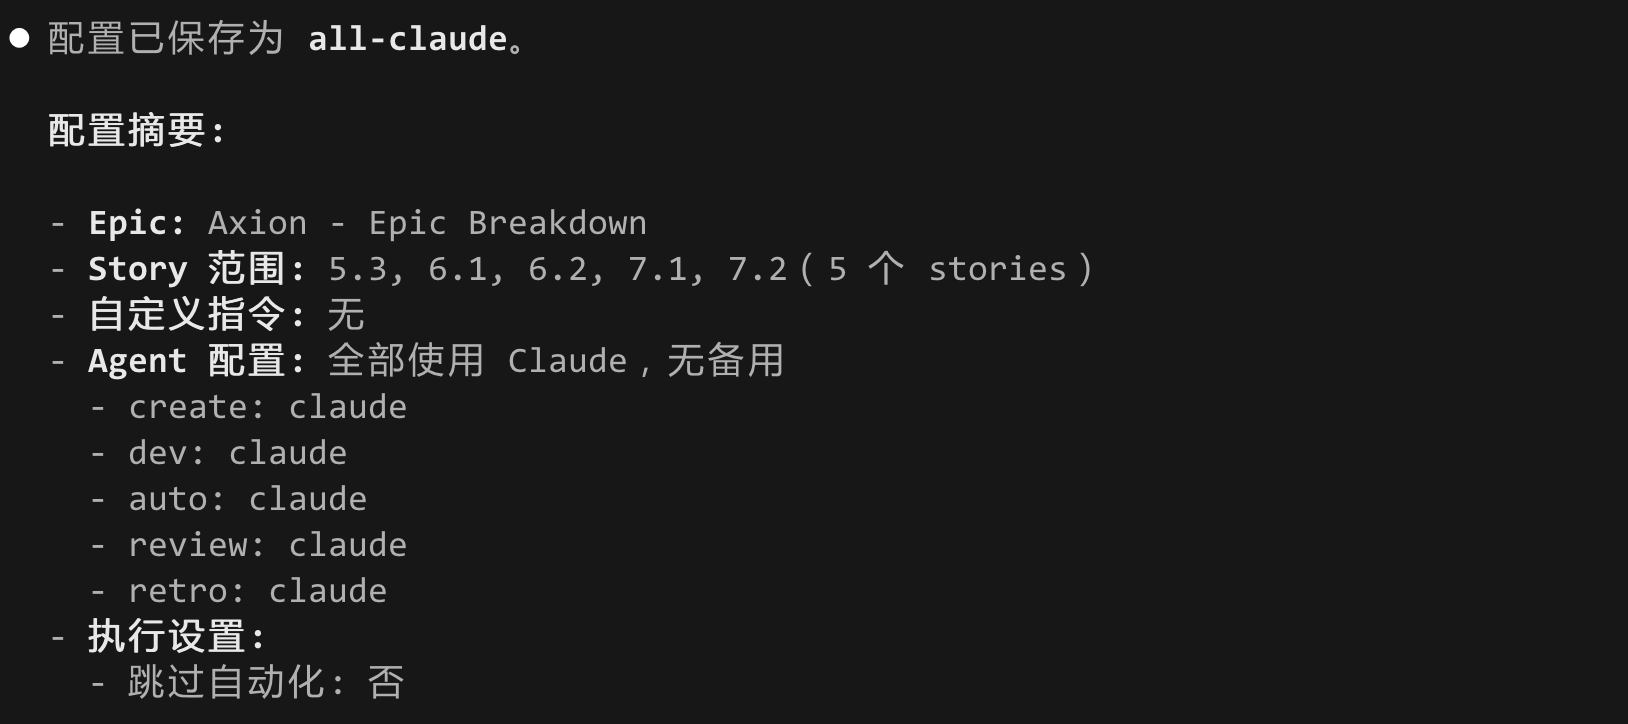
摘要里写了几件事:
- Epic 是哪个
- Story 范围是什么
- 自定义指令有没有
- create / dev / auto / review / retro 分别用什么 Agent
- 是否跳过自动化
这类“摘要页”看起来很普通,但它是编排器可恢复、可审计、可复盘的基础。
因为自动化一旦跨越多个 Story、多次会话、多个阶段,就一定会面对这些问题:
- 中途停了怎么办?
- 我这次到底选了什么配置?
- 为什么这批 Story 用的是这个 Agent 组合?
有了显式保存的配置,后续无论是恢复执行还是事后分析,都不会变成猜谜游戏。
实际体验结论
昨晚睡觉前,我直接把这 5 个 Story 交给 Story Automator 去跑。早上起来看结果,它总共跑了 5 个半小时。
坦白说,速度是比我自己手工盯着跑要慢的。按我平时的节奏,这 5 个 Story 如果自己来,估计 3 个小时内能收完。至于为什么会慢这么多, 具体原因还不太清楚, 还没有仔细的去分析它的实现原理,不过目前还只是试验版,能跑通比较重要。
目前比较适合:睡觉前梭一把。
另外一个我觉得做得不错的点,是每个 Epic 跑完之后,它会顺手做一次复盘,把有用的信息补到 project-context.md 里。
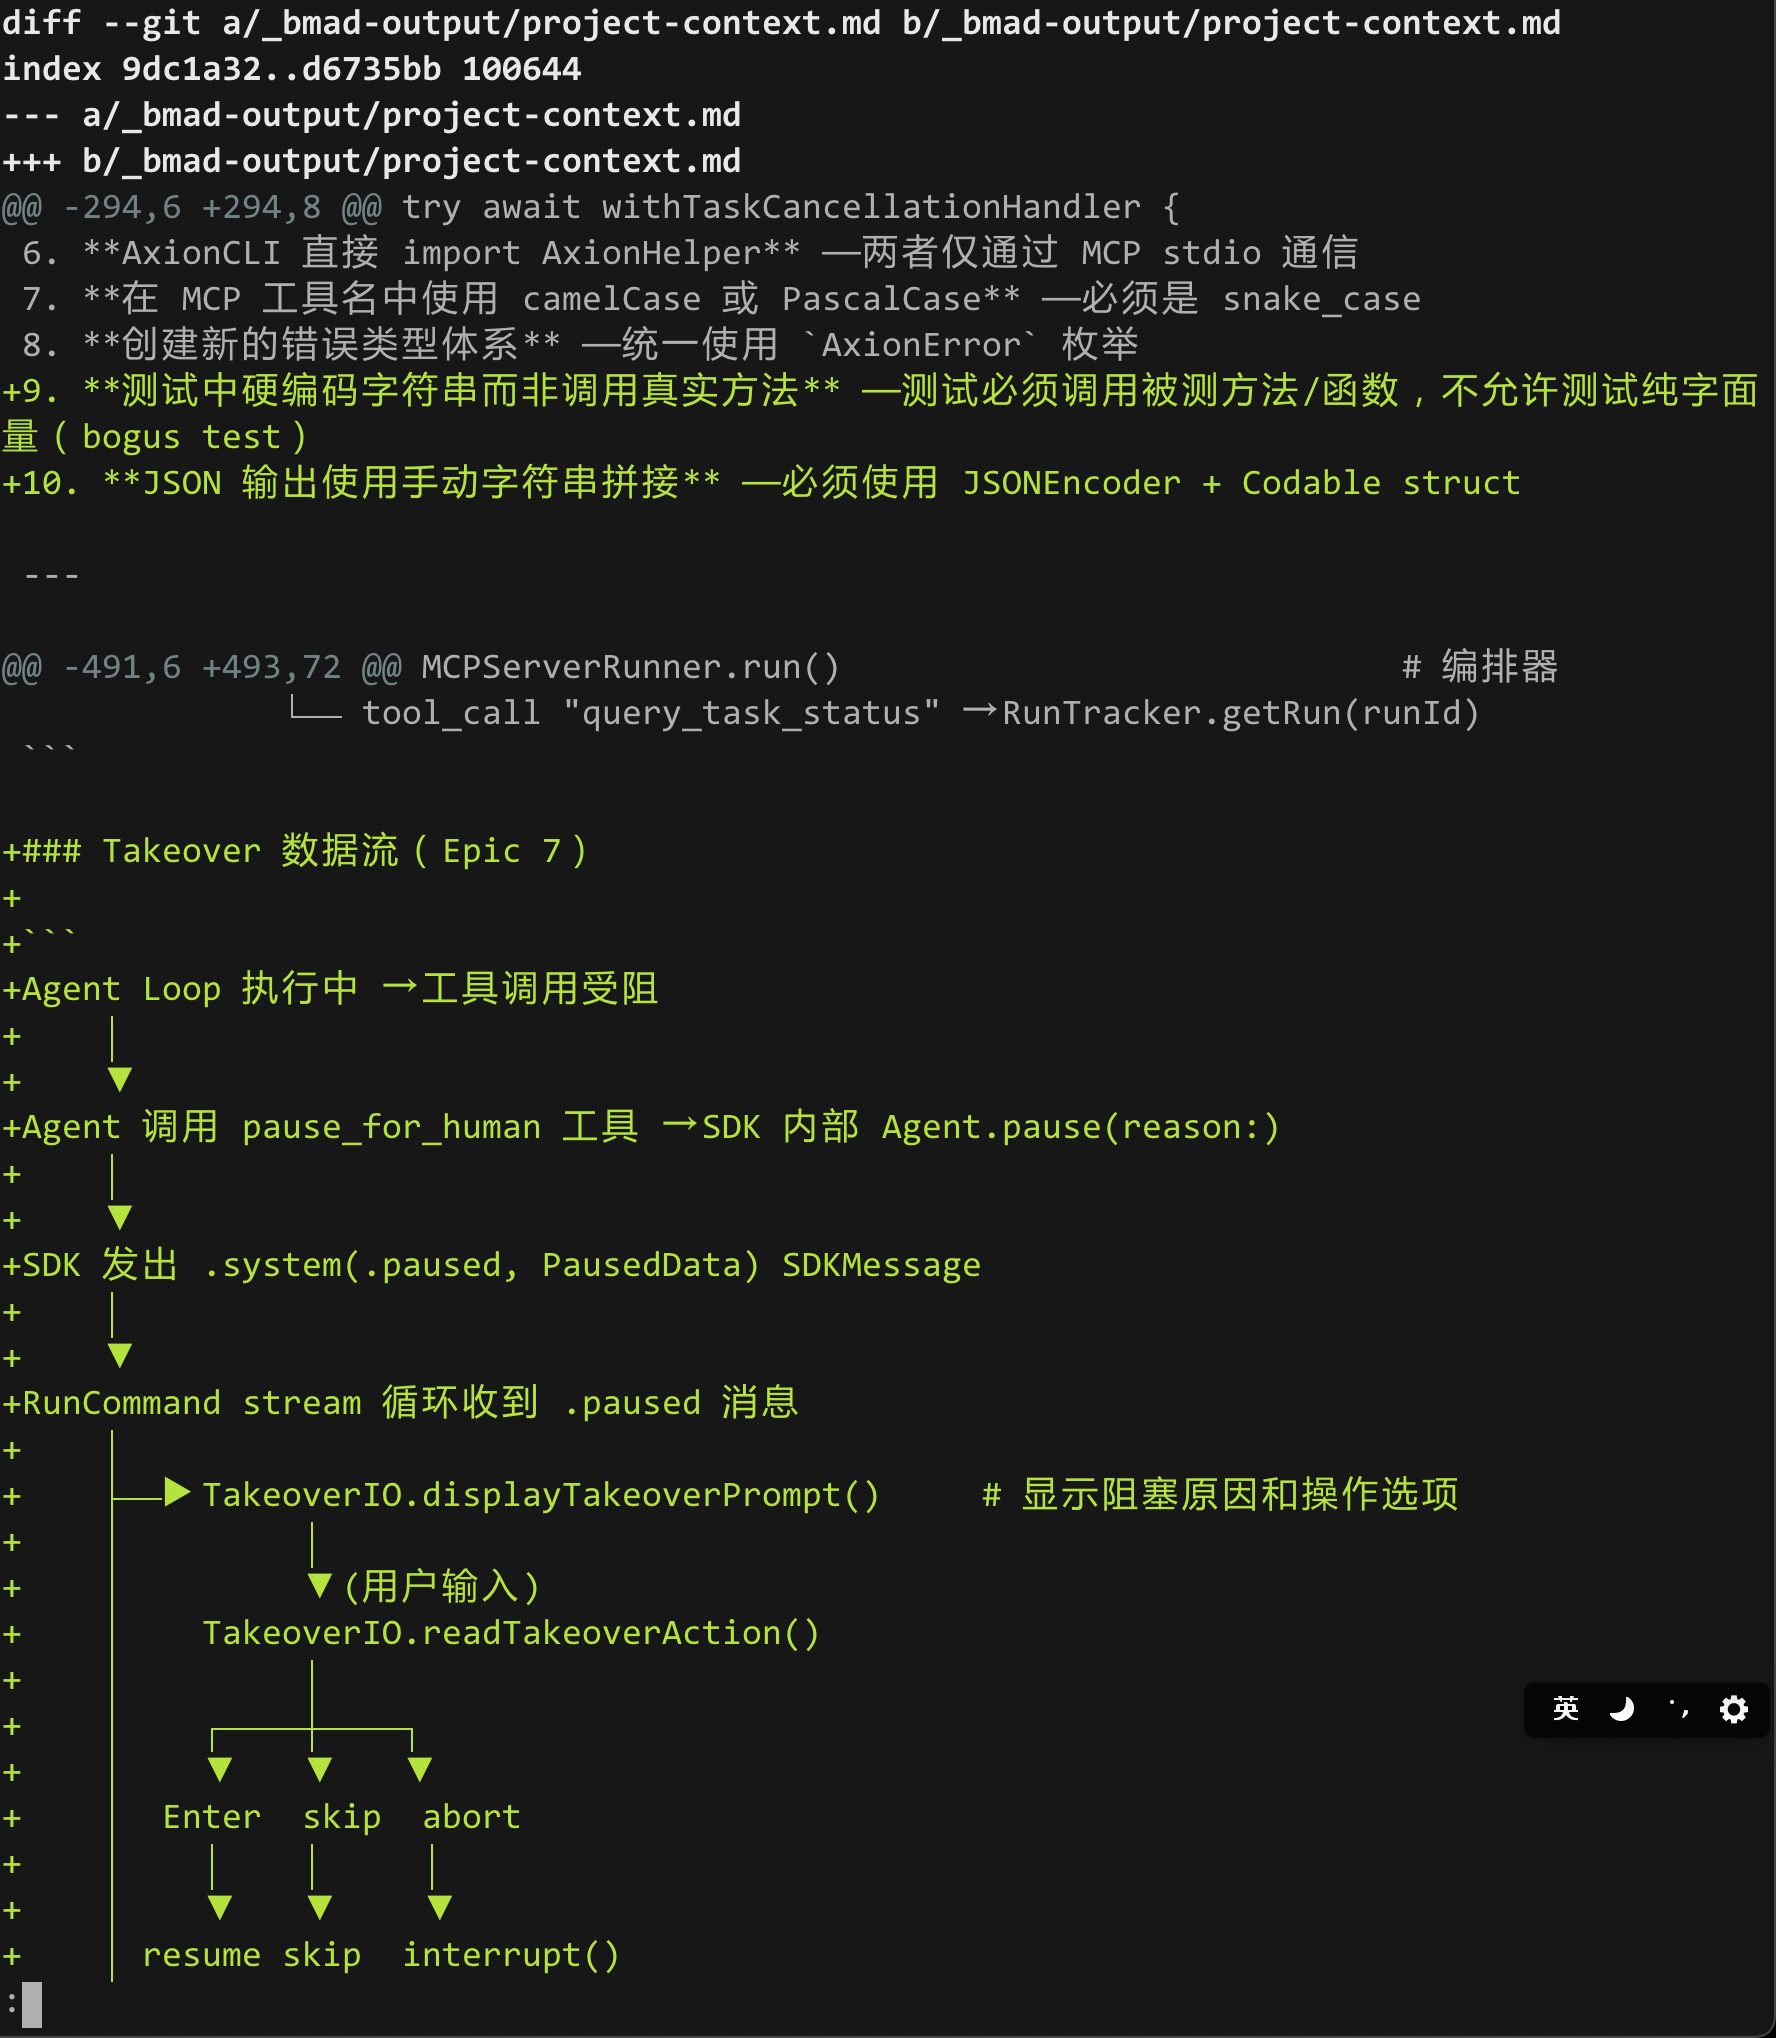
所以我现在对它的看法很简单:
白天手工跑,目前还是自己手工跑会更快。
但睡前把一批 Story 交给它过夜跑,这个场景它真的挺合适。
如果你正在使用 BMAD 来开发项目,你一定要试一下 Story Automator,它可能是你将重复协调时间从小时级降到分钟级的工具。
本文是「深入 SwiftWork」系列第 4 篇(完结篇)。系列目录见这里。
前三篇讲了事件怎么从 SDK 流到 UI、时间线怎么渲染、工具卡片怎么可视化。这篇收尾,看 SwiftWork 的基础设施——数据怎么存、状态怎么恢复、Markdown 怎么渲染、代码怎么高亮、API Key 怎么管。
这些组件各自独立,但都是"让应用可用"的必要部分。
SwiftData 模型层
SwiftWork 用 SwiftData 做持久化,注册了四个模型:
// SwiftWorkApp.swift
.modelContainer(for: [
    Session.self,
    Event.self,
    AppConfiguration.self,
    PermissionRule.self
])
Session
@Model
final class Session {
    @Attribute(.unique) var id: UUID
    var title: String
    var createdAt: Date
    var updatedAt: Date
    var workspacePath: String?
    @Relationship(deleteRule: .cascade, inverse: \Event.session)
    var events: [Event]
}
@Relationship(deleteRule: .cascade) 意味着删除 Session 时自动删除它下面所有 Event。workspacePath 是可选的——用户可以给每个会话指定不同的工作目录。
Event
@Model
final class Event {
    @Attribute(.unique) var id: UUID
    var sessionID: UUID
    var eventType: String
    var rawData: Data        // JSON 序列化的 AgentEvent
    var timestamp: Date
    var order: Int
    var session: Session?
}
第 1 篇讲过这个设计——rawData 是整个 AgentEvent 序列化后的 JSON blob。不拆成独立字段的原因是 metadata 的结构因事件类型而异,拆字段会导致大量空列和 Schema 频繁变更。
AppConfiguration
@Model
final class AppConfiguration {
    @Attribute(.unique) var id: UUID
    var key: String
    var value: Data
    var updatedAt: Date
}
通用的 key-value 存储。用 SwiftData 实现而不是 UserDefaults,因为 SwiftData 支持 async 访问、数据迁移和 iCloud 同步(将来可能用到)。存的值包括:
hasCompletedOnboarding— 是否完成首次引导selectedModel— 用户选择的模型lastActiveSessionID— 上次活跃的会话 IDwindowFrame— 窗口位置和大小inspectorVisible— Inspector 面板是否可见
AppStateManager:应用状态恢复
AppStateManager 负责在 App 重启后恢复用户的工作状态——上次打开的会话、窗口位置、Inspector 面板的开关。
@MainActor
@Observable
final class AppStateManager {
    var lastActiveSessionID: UUID?
    var windowFrame: NSRect?
    var isInspectorVisible: Bool = false

    func loadAppState() {
        lastActiveSessionID = loadUUID(key: "lastActiveSessionID")
        windowFrame = loadNSRect(key: "windowFrame")
        isInspectorVisible = loadBool(key: "inspectorVisible")
    }

    func saveLastActiveSessionID(_ id: UUID?) { ... }
    func saveWindowFrame(_ frame: NSRect) { ... }
    func saveInspectorVisibility(_ visible: Bool) { ... }
}
底层用 AppConfiguration 的 key-value 存取:
private func saveString(_ string: String, forKey key: String) {
    let descriptor = FetchDescriptor<AppConfiguration>(
        predicate: #Predicate { $0.key == key }
    )
    if let existing = try? modelContext.fetch(descriptor).first {
        existing.value = Data(string.utf8)
    } else {
        let config = AppConfiguration(key: key, value: Data(string.utf8))
        modelContext.insert(config)
    }
    try? modelContext.save()
}
upsert 逻辑——先查有没有,有就更新,没有就插入。loadNSRect 把字符串转回 NSRect(用 NSRectFromString),loadBool 比较字符串 "true"。
保存时机
状态保存不是在 App 退出时一次性完成的,而是在各个触发点分散保存:
| 状态 | 保存时机 |
|---|---|
lastActiveSessionID |
用户切换会话时(SessionViewModel.selectSession) |
windowFrame |
窗口移动/缩放时(500ms 节流)+ App 退出时 |
inspectorVisible |
Inspector 面板切换时 |
窗口位置的保存做了节流——didMoveNotification 和 didResizeNotification 触发频率很高,每次都写 SwiftData 不值得。用一个 500ms 的 Task.sleep 做防抖,只有最后一次移动/缩放才会真正保存:
// ContentView.swift
let saveWindowFrameThrottled: (Notification) -> Void = { _ in
    saveTask?.cancel()
    saveTask = Task { @MainActor in
        try? await Task.sleep(for: .milliseconds(500))
        guard !Task.isCancelled else { return }
        if let window = mainWindow {
            appStateManager.saveWindowFrame(window.frame)
        }
    }
}
恢复流程
App 启动时,ContentView.task 触发恢复:
.task {
    settingsViewModel.configure(modelContext: modelContext)
    hasCompletedOnboarding = settingsViewModel.isAPIKeyConfigured
        && !settingsViewModel.isFirstLaunch

    if hasCompletedOnboarding == true {
        configureAndRestoreState()
    }
}
configureAndRestoreState 按顺序恢复:
- 初始化
AppStateManager,加载保存的状态 - 初始化
SessionViewModel,获取会话列表 - 根据
lastActiveSessionID选中对应会话 - 恢复
isInspectorVisible - 恢复窗口位置(如果 window 引用已经到达)
窗口位置的恢复有一个时序问题——WindowAccessor 的回调是异步的,window 引用可能在 task 之后才到达。所以 onChange(of: mainWindow) 里也做了恢复:
.onChange(of: mainWindow) { _, newWindow in
    if let newWindow {
        restoreWindowFrame(in: newWindow)
    }
}
MarkdownRenderer:Visitor 模式渲染 Markdown
Agent 的回复是 Markdown 格式的——标题、列表、代码块、粗体、链接。SwiftWork 用 Apple 的 swift-markdown 库解析 Markdown,然后用 Visitor 模式遍历 AST,生成 SwiftUI 视图。
为什么不用现成的 Markdown 渲染组件
macOS 上的 Markdown 渲染组件不多。AttributedString(markdown:) 只支持基础格式(粗体、链接),不支持代码块、表格、引用块。WebView 方案(用 Markdown.js 渲染到 HTML)引入了 WebKit 的依赖和内存开销。手写 Visitor 可以精确控制每个元素的渲染方式,而且不引入额外依赖。
Visitor 实现
private struct MarkdownToViewsVisitor: @preconcurrency MarkupVisitor {
    private(set) var views: [AnyView] = []

    mutating func visitHeading(_ heading: Heading) -> Result { ... }
    mutating func visitParagraph(_ paragraph: Paragraph) -> Result { ... }
    mutating func visitCodeBlock(_ codeBlock: CodeBlock) -> Result { ... }
    mutating func visitUnorderedList(_ unorderedList: UnorderedList) -> Result { ... }
    mutating func visitOrderedList(_ orderedList: OrderedList) -> Result { ... }
    mutating func visitBlockQuote(_ blockQuote: BlockQuote) -> Result { ... }
    mutating func visitTable(_ table: Table) -> Result { ... }
    mutating func visitThematicBreak(_ thematicBreak: ThematicBreak) -> Result { ... }
}
每个 visit 方法处理一种 Markdown 节点,把生成的视图追加到 views 数组。最终 MarkdownRenderer.render() 返回这个数组,MarkdownContentView 用 ForEach 渲染。
内联格式处理
段落、列表项里的内联格式(粗体、斜体、行内代码、链接)通过 collectAttributedString 处理。它递归遍历子节点,构建 AttributedString:
private mutating func collectAttributedString(from markup: any Markup) -> AttributedString {
    var result = AttributedString()
    for child in markup.children {
        if let strong = child as? Strong {
            var s = collectAttributedString(from: strong)
            s.font = .body.bold()
            result.append(s)
        } else if let emphasis = child as? Emphasis {
            var e = collectAttributedString(from: emphasis)
            e.font = .body.italic()
            result.append(e)
        } else if let inlineCode = child as? InlineCode {
            var codeAttr = AttributedString(inlineCode.code)
            codeAttr.backgroundColor = Color.primary.opacity(0.06)
            codeAttr.font = .system(.body, design: .monospaced)
            result.append(codeAttr)
        } else if let link = child as? MarkdownLink {
            var linkAttr = AttributedString(collectInlineText(from: link))
            linkAttr.foregroundColor = Color.accentColor
            linkAttr.underlineStyle = .single
            linkAttr.link = URL(string: link.destination)
            result.append(linkAttr)
        }
        // ... SoftBreak, LineBreak, Strikethrough
    }
    return result
}
AttributedString 是 SwiftUI 原生支持的富文本类型。把它传给 SwiftUI.Text(attributed),SwiftUI 会按设定的 font、color、backgroundColor 渲染。行内代码得到灰色背景的等宽字体,链接得到蓝色下划线。
类型名冲突
swift-markdown 和 SwiftUI 有类型名冲突——两者都有 Text、Link 等类型。解决方案是用 typealias:
private typealias MarkdownText = Markdown.Text
private typealias MarkdownLink = Markdown.Link
在 visitor 内部用 MarkdownText 和 MarkdownLink 引用 swift-markdown 的类型,SwiftUI.Text 引用 SwiftUI 的类型。
CodeHighlighter:Splash 代码高亮
代码块的高亮用 John Sundell 的 Splash 库。目前只支持 Swift 语法高亮,其他语言 fallback 到等宽纯文本:
enum CodeHighlighter {
    static func highlight(code: String, language: String?) -> AnyView {
        let trimmedLanguage = language?.lowercased()
        if trimmedLanguage == "swift" {
            return highlightedSwiftView(code: code)
        } else {
            return plainCodeView(code: code)
        }
    }

    private static func highlightedSwiftView(code: String) -> AnyView {
        let theme = Theme.sundellsColors(withFont: Splash.Font(size: 13))
        let format = AttributedStringOutputFormat(theme: theme)
        let highlighter = SyntaxHighlighter(format: format)
        let attributed = try? AttributedString(highlighter.highlight(code), including: \.appKit)
        return AnyView(Text(attributed ?? AttributedString(code)))
    }
}
Splash 的管线:源码字符串 → SyntaxHighlighter → AttributedStringOutputFormat → NSAttributedString → AttributedString → SwiftUI.Text。
为什么只支持 Swift?因为 Splash 只支持 Swift。如果要支持 Python/JavaScript/Bash,需要换一个多语言的高亮库(比如 Highlight.js 的 Swift wrapper),或者用 Tree-sitter。目前 Swift 代码块的高亮频率最高(SwiftWork 本身是 Swift 项目),先支持 Swift 够用。
KeychainManager:API Key 安全存储
API Key 不能明文存在 SwiftData 或 UserDefaults 里。SwiftWork 用 macOS Keychain 存储:
struct KeychainManager: KeychainManaging, Sendable {
    func save(key: String, data: Data) throws {
        let query = [
            kSecClass: kSecClassGenericPassword,
            kSecAttrService: service,
            kSecAttrAccount: key
        ]
        let status = SecItemAdd(query.merging([kSecValueData: data]), nil)
        if status == errSecDuplicateItem {
            SecItemUpdate(query, [kSecValueData: data])
        }
    }

    func load(key: String) throws -> Data? {
        let query = [
            kSecClass: kSecClassGenericPassword,
            kSecAttrService: service,
            kSecAttrAccount: key,
            kSecReturnData: true,
            kSecMatchLimit: kSecMatchLimitOne
        ]
        var result: AnyObject?
        let status = SecItemCopyMatching(query, &result)
        if status == errSecItemNotFound { return nil }
        return result as? Data
    }
}
KeychainManaging 协议抽象了底层实现,方便测试时 mock。协议扩展提供了 saveAPIKey/getAPIKey/deleteAPIKey 的便捷方法。
Keychain 存储有两个好处:数据加密(系统级别的),以及不受 App Sandbox 的文件访问限制。
TitleGenerator:自动生成会话标题
新建的会话标题是"新会话"。Agent 第一次执行完成后,TitleGenerator 用 LLM 根据对话内容生成一个简短的标题:
enum TitleGenerator {
    static func generate(events: [AgentEvent], apiKey: String, ...) async -> String? {
        guard !apiKey.isEmpty else { return nil }

        let messages = events
            .filter { $0.type == .userMessage || $0.type == .assistant }
            .suffix(10)  // 只取最近 10 条
            .map { ["role": ..., "content": String($0.content.prefix(500))] }

        let body = [
            "model": model,
            "max_tokens": 50,
            "system": "根据以下对话内容,生成一个简短的标题(最多20个字符)。只输出标题。",
            "messages": messages
        ]
        // 调 LLM API,返回标题文本
    }
}
触发时机在 WorkspaceView.setupTitleGeneration 里——通过 AgentBridge.onResult 回调,在 Agent 执行完成且会话标题还是"新会话"时触发:
agentBridge.onResult = { [weak session] _ in
    guard let session, session.title == "新会话" else { return }
    if let title = await TitleGenerator.generate(events: events, ...) {
        sessionViewModel.updateSessionTitle(session, title: title)
    }
}
这是一个轻量的 LLM 调用——只有 50 token 的输出限制,system prompt 很短,取最近的 10 条消息、每条截断到 500 字符。实测延迟在 1-2 秒,不影响用户体验。
总结
SwiftWork 的数据层和服务组件各司其职:
| 组件 | 职责 |
|---|---|
| SwiftData | Session/Event/AppConfiguration 持久化 |
| AppStateManager | 应用状态恢复(会话、窗口、面板) |
| EventStore | 事件持久化协议,SwiftData 实现 |
| MarkdownRenderer | swift-markdown AST → SwiftUI 视图 |
| CodeHighlighter | Splash 语法高亮(Swift) |
| KeychainManager | API Key 安全存储 |
| TitleGenerator | LLM 自动生成会话标题 |
它们是前几篇讲的核心管线(AgentBridge → EventMapper → TimelineView)之外的"支撑层"。没有它们应用也能跑,但用户体验会差很多——没有持久化意味着每次重启都从零开始,没有 Markdown 渲染意味着 Agent 的回复是一堆原始文本,没有 Keychain 管理意味着 API Key 明文存储。
系列文章:
- 第 0 篇:用 SwiftUI 构建一个 Agent 可视化工作台
- 第 1 篇:SDK 集成层——把 AsyncStream 接进 SwiftUI
- 第 2 篇:事件时间线——18 种事件的可视化与性能
- 第 3 篇:Tool Card——可扩展的工具可视化系统
- 第 4 篇:数据层与服务——SwiftData、状态恢复与 Markdown 渲染(本文)
相关链接:
- SwiftWork:terryso/SwiftWork
- Open Agent SDK:terryso/open-agent-sdk-swift
本文是「深入 SwiftWork」系列第 3 篇。系列目录见这里。
前两篇讲了事件怎么从 SDK 流到 UI。这篇聚焦其中一类事件——工具调用的可视化。
Agent 调工具是 Agent 应用里最频繁的操作。一次典型任务可能调用二三十次工具——读文件、写文件、执行命令、搜索代码。如果每次工具调用都显示成一样的灰色方块,用户很难快速区分"Bash 在跑什么命令"、"Edit 在改哪个文件"。
SwiftWork 的解决方案是一套可扩展的工具渲染系统:每种工具注册一个渲染器,ToolCardView 根据工具名称查找对应的渲染器来显示。新增工具类型时,只需要写一个实现 ToolRenderable 协议的 struct,注册到 ToolRendererRegistry,不用改 TimelineView 的任何代码。
从问题出发:为什么不用统一的工具视图
最简单的做法是给所有工具调用用同一个视图——显示工具名称、输入参数、输出结果。第 2 篇里的 ToolCallView 就是这个角色:
struct ToolCallView: View {
    let event: AgentEvent
    var body: some View {
        VStack(alignment: .leading, spacing: 4) {
            HStack(spacing: 4) {
                Image(systemName: "wrench.and.screwdriver")
                Text(event.content)  // 工具名称
            }
            Text(input)  // 原始 JSON
        }
    }
}
这个视图对所有工具一视同仁——同样的扳手图标,同样的 JSON 输出。它作为 fallback 够用,但有几个问题:
- Bash 调用时,用户想看到的是命令本身(
git status),不是{"command": "git status"} - Read 调用时,用户想看到的是文件路径(
src/main.swift),不是完整的 JSON - 搜索工具的结果可能是多行匹配,需要和单行输出区分开
每个工具都有不同的"最有用的信息"。Tool Card 系统就是让每个工具自己决定怎么展示。
ToolRenderable 协议
协议定义了工具渲染器的契约:
protocol ToolRenderable: Sendable {
    /// 此渲染器处理的工具名称(与 SDK ToolUseData.toolName 匹配)
    static var toolName: String { get }

    /// 工具类型主题色(左边条、图标着色)
    static var accentColor: Color { get }

    /// 工具类型 SF Symbol 图标名
    static var icon: String { get }

    /// 根据工具内容生成 SwiftUI 视图
    @ViewBuilder @MainActor
    func body(content: ToolContent) -> any View

    /// 生成摘要标题(折叠状态显示)
    func summaryTitle(content: ToolContent) -> String

    /// 生成副标题(如文件路径、命令摘要)
    func subtitle(content: ToolContent) -> String?
}
协议扩展提供了默认值:
extension ToolRenderable {
    static var accentColor: Color { .gray }
    static var icon: String { "wrench.and.screwdriver" }

    func summaryTitle(content: ToolContent) -> String {
        content.toolName
    }

    func subtitle(content: ToolContent) -> String? {
        nil
    }
}
六个成员,三个有默认值。实现者只需要提供 toolName(静态路由键)和 body(渲染内容)。summaryTitle 和 subtitle 可以覆盖来提供更有意义的摘要,accentColor 和 icon 可以覆盖来做视觉区分。
ToolRendererRegistry
注册表是一个 [String: ToolRenderable] 字典,用 toolName 做键:
@MainActor
@Observable
final class ToolRendererRegistry {
    private var renderers: [String: any ToolRenderable] = [:]

    init() {
        register(BashToolRenderer())
        register(FileEditToolRenderer())
        register(SearchToolRenderer())
        register(ReadToolRenderer())
        register(WriteToolRenderer())
    }

    func register(_ renderer: any ToolRenderable) {
        renderers[type(of: renderer).toolName] = renderer
    }

    func renderer(for toolName: String) -> (any ToolRenderable)? {
        renderers[toolName]
    }
}
init 时预注册 5 个内置渲染器。查找是 O(1) 的字典访问。@Observable 标记让 SwiftUI 在注册新渲染器时自动刷新——虽然目前的用法里渲染器在 init 时就注册完了,动态注册是留给插件系统准备的。
5 个内置渲染器
BashToolRenderer——终端命令
struct BashToolRenderer: ToolRenderable {
    static let toolName = "Bash"
    static let accentColor: Color = .green
    static let icon: String = "terminal"

    func summaryTitle(content: ToolContent) -> String {
        // 从 input JSON 提取 command 字段
        // {"command": "git status"} → "git status"
        guard let json = parseInput(content),
              let command = json["command"] as? String
        else { return content.toolName }
        return command
    }
}
绿色主题 + 终端图标。summaryTitle 从 input JSON 提取 command 字段——折叠状态下用户直接看到正在跑什么命令。
ReadToolRenderer——文件读取
struct ReadToolRenderer: ToolRenderable {
    static let toolName = "Read"
    static let accentColor: Color = .blue
    static let icon: String = "doc.text"

    func summaryTitle(content: ToolContent) -> String {
        // {"file_path": "src/main.swift"} → "src/main.swift"
        guard let json = parseInput(content),
              let filePath = json["file_path"] as? String
        else { return content.toolName }
        return filePath
    }
}
蓝色主题 + 文档图标。summaryTitle 提取文件路径。
WriteToolRenderer——文件写入
struct WriteToolRenderer: ToolRenderable {
    static let toolName = "Write"
    static let accentColor: Color = .orange
    static let icon: String = "pencil.and.outline"

    func summaryTitle(content: ToolContent) -> String {
        // 提取 file_path
    }

    func subtitle(content: ToolContent) -> String? {
        // 提取 content 字段,截取前 80 字符
        // {"content": "import Foundation\n..."} → "import Foundation..."
        guard let json = parseInput(content),
              let contentStr = json["content"] as? String, !contentStr.isEmpty
        else { return nil }
        return "\(contentStr.prefix(80))..."
    }
}
橙色主题 + 铅笔图标。比 Read 多一个 subtitle——显示写入内容的前 80 个字符。因为写入的内容通常很长,subtitle 给用户一个快速预览。
FileEditToolRenderer——文件编辑
struct FileEditToolRenderer: ToolRenderable {
    static let toolName = "Edit"
    static let accentColor: Color = .orange
    static let icon: String = "pencil.line"

    func summaryTitle(content: ToolContent) -> String {
        // 提取 file_path
    }

    func subtitle(content: ToolContent) -> String? {
        // 提取 old_string,截取前 50 字符
        // {"old_string": "func hello() {"} → "Editing: func hello() {"
        guard let json = parseInput(content),
              let oldString = json["old_string"] as? String, !oldString.isEmpty
        else { return nil }
        return "Editing: \(oldString.prefix(50))"
    }
}
橙色主题 + 编辑图标。subtitle 显示被替换的旧文本片段——让用户知道 Edit 在改哪一行。
SearchToolRenderer——代码搜索
struct SearchToolRenderer: ToolRenderable {
    static let toolName = "Grep"
    static let accentColor: Color = .purple
    static let icon: String = "text.magnifyingglass"

    func summaryTitle(content: ToolContent) -> String {
        // 提取 pattern
    }

    func subtitle(content: ToolContent) -> String? {
        // 提取 path
    }
}
紫色主题 + 放大镜图标。summaryTitle 显示搜索 pattern,subtitle 显示搜索路径。
视觉区分一览
| 工具 | 颜色 | 图标 | summaryTitle | subtitle |
|---|---|---|---|---|
| Bash | 绿色 | terminal | 命令 | - |
| Read | 蓝色 | doc.text | 文件路径 | - |
| Write | 橙色 | pencil.and.outline | 文件路径 | 内容前 80 字符 |
| Edit | 橙色 | pencil.line | 文件路径 | 被替换文本前 50 字符 |
| Grep | 紫色 | text.magnifyingglass | 搜索 pattern | 搜索路径 |
五种工具在折叠状态下就能一眼区分:颜色不同、图标不同、摘要文本不同。
ToolCardView:容器视图
ToolCardView 是工具卡片的容器。它不做具体的渲染,而是委托给注册表里查到的渲染器:
struct ToolCardView: View {
    let content: ToolContent
    let registry: ToolRendererRegistry
    let isSelected: Bool
    let onSelect: () -> Void

    @State private var isExpanded = false

    var body: some View {
        HStack(spacing: 0) {
            // 左边条(3px,渲染器的主题色)
            RoundedRectangle(cornerRadius: 2)
                .fill(toolAccentColor)
                .frame(width: 3)

            VStack(alignment: .leading, spacing: 0) {
                titleRow       // 始终可见
                    .onTapGesture {
                        onSelect()
                        withAnimation { isExpanded.toggle() }
                    }

                if isExpanded {
                    expandedContent  // 展开后可见
                }
            }
        }
    }
}
卡片分两层:titleRow(始终可见)和 expandedContent(点击展开)。
titleRow
private var titleRow: some View {
    HStack(alignment: .top, spacing: 6) {
        Image(systemName: toolIcon)          // 渲染器的图标
            .foregroundStyle(toolIconColor)

        VStack(alignment: .leading, spacing: 2) {
            HStack(spacing: 4) {
                Text(resolvedSummaryTitle)    // 渲染器的 summaryTitle
                    .fontWeight(.medium)
                Spacer()
                if content.status == .running {
                    ProgressView().controlSize(.mini)  // 运行中转圈
                }
                Text(statusLabel)             // pending / running / completed / failed
                    .font(.system(size: 9))
                    .background(statusColor.opacity(0.15))
            }
            Text(content.toolName)            // 工具名称(小字)
            if let subtitle = resolvedSubtitle {  // 渲染器的 subtitle
                Text(subtitle)
            }
        }
    }
}
标题行从渲染器获取图标、颜色、摘要标题和副标题。状态标签(pending/running/completed/failed)由 ToolContent.status 决定,不在渲染器的控制范围内——它是通用的执行状态,跟工具类型无关。
expandedContent
private var expandedContent: some View {
    VStack(alignment: .leading, spacing: 8) {
        Divider()

        // 工具特定的 body(从渲染器获取)
        if let renderer = registry.renderer(for: content.toolName) {
            AnyView(renderer.body(content: content))
        } else {
            genericToolBody  // fallback
        }

        // 通用 INPUT 区域
        if !content.input.isEmpty {
            HStack {
                Text("INPUT")
                Spacer()
                CopyButton(text: content.input)
            }
            Text(content.input)
                .font(.system(.caption, design: .monospaced))
        }

        // 通用 OUTPUT 区域
        if let output = content.output, !output.isEmpty {
            ToolResultContentView(output: output, isError: content.isError)
        }
    }
}
展开内容分三块:
- 渲染器的
body:工具特定的自定义内容。目前的 5 个内置渲染器都在body里显示了一个带图标的摘要块——和titleRow里的信息类似但更详细。将来可以为复杂工具(比如显示代码 diff 预览)提供更丰富的body。 - INPUT 区域:通用的原始输入 JSON 展示,带复制按钮。
- OUTPUT 区域:
ToolResultContentView,下一节讲。
genericToolBody 是没有注册渲染器时的 fallback——只显示工具名和原始输入。
ToolResultContentView:输出渲染 + Diff 检测
ToolResultContentView 有一个智能功能:自动检测输出内容是不是 diff 格式,如果是就用颜色标注。
private var isDiffContent: Bool {
    let lines = output.components(separatedBy: "\n")
    let diffLines = lines.filter { $0.hasPrefix("+") || $0.hasPrefix("-") || $0.hasPrefix("@@") }
    return diffLines.count >= 2
}
检测逻辑:如果输出里至少有两行以 +、-、@@ 开头,就认为是 diff 内容。简单但够用——SDK 的 Edit 工具输出 diff 格式的结果。
Diff 渲染给每行加背景色:
private func diffLineView(_ line: String) -> some View {
    Text(line)
        .font(.system(.caption, design: .monospaced))
        .padding(.horizontal, 4)
        .background(diffLineBackground(line))
}

private func diffLineBackground(_ line: String) -> Color {
    if line.hasPrefix("+") { return .green.opacity(0.15) }  // 新增行
    if line.hasPrefix("-") { return .red.opacity(0.15) }    // 删除行
    if line.hasPrefix("@@") { return .blue.opacity(0.1) }   // 位置标记
    return .clear
}
非 diff 内容按普通文本渲染,有截断逻辑——超过 5 行或 200 字符时折叠,带展开按钮。
怎么新增一个工具渲染器
假设 SDK 新增了一个 WebFetch 工具,你想在 SwiftWork 里给它一个专属的卡片样式。只需要两个步骤:
第一步:写渲染器
struct WebFetchToolRenderer: ToolRenderable {
    static let toolName = "WebFetch"
    static let accentColor: Color = .cyan
    static let icon: String = "globe"

    @MainActor
    func body(content: ToolContent) -> any View {
        // 自定义视图...
    }

    func summaryTitle(content: ToolContent) -> String {
        // 从 input 提取 URL
        guard let json = parseInput(content),
              let url = json["url"] as? String
        else { return content.toolName }
        return url
    }
}
第二步:注册
// ToolRendererRegistry.init()
register(WebFetchToolRenderer())
不需要改 TimelineView、ToolCardView 或任何其他文件。ToolCardView 在渲染时通过 registry.renderer(for:) 查找渲染器,查到了就用,查不到就用 fallback。
总结
Tool Card 系统的设计思路是协议 + 注册表:
| 组件 | 职责 |
|---|---|
ToolRenderable |
定义渲染契约——工具名、颜色、图标、摘要、自定义视图 |
ToolRendererRegistry |
字典查找,toolName → ToolRenderable |
ToolCardView |
容器视图,委托给渲染器,处理通用逻辑(展开/折叠、状态标签、INPUT/OUTPUT 区域) |
ToolResultContentView |
输出渲染,自动 diff 检测 |
这个模式的好处是开放扩展、关闭修改。TimelineView 的分派逻辑(第 2 篇的 toolCardView(for:))不需要知道有多少种工具——它只查注册表。新增工具类型时,改动的范围限定在渲染器文件和注册表的 init 方法。
下一篇是最后一篇,看数据层——SwiftData 的会话/事件持久化、App 状态恢复、Markdown 渲染和代码高亮。
系列文章:
- 第 0 篇:用 SwiftUI 构建一个 Agent 可视化工作台
- 第 1 篇:SDK 集成层——把 AsyncStream 接进 SwiftUI
- 第 2 篇:事件时间线——18 种事件的可视化与性能
- 第 3 篇:Tool Card——可扩展的工具可视化系统(本文)
- 第 4 篇:数据层与服务——SwiftData、状态恢复与 Markdown 渲染
相关链接:
- SwiftWork:terryso/SwiftWork
- Open Agent SDK:terryso/open-agent-sdk-swift
本文是「深入 SwiftWork」系列第 2 篇。系列目录见这里。
第 1 篇讲了 AgentBridge 怎么把 SDK 的 AsyncStream<SDKMessage> 变成 [AgentEvent]。这篇看 [AgentEvent] 变成什么——TimelineView 怎么渲染 18 种事件、怎么处理滚屏行为、怎么在事件量很大时保持流畅。
TimelineView 的结构
TimelineView 是工作区的主体,占满了侧边栏和输入框之间的所有空间。它的视图层级很浅:
TimelineView
  ├── ScrollView
  │   ├── topPlaceholder (虚拟化占位)
  │   ├── LazyVStack
  │   │   └── ForEach(virtualizedEvents) → eventView(for:)
  │   ├── bottomPlaceholder (虚拟化占位)
  │   ├── StreamingTextView (流式文本)
  │   └── bottom-anchor (滚动锚点)
  └── returnToBottomButton (回到底部)
没有事件时显示空状态:"发送消息开始与 Agent 对话"。有事件时进入 ScrollViewReader + LazyVStack 的结构。
事件分派:18 种类型到 8 种视图
eventView(for:) 是事件分派的核心。18 种 AgentEventType 映射到 8 种视图:
@ViewBuilder
private func eventView(for event: AgentEvent) -> some View {
    switch event.type {
    case .userMessage:       UserMessageView(event: event)
    case .partialMessage:    EmptyView()
    case .assistant:         AssistantMessageView(event: event)
    case .toolUse:           toolCardView(for: event)
    case .toolResult,
         .toolProgress:      pairedToolEventView(for: event)
    case .result:            ResultView(event: event)
    case .system:            systemOrThinking(event: event)
    case .hookStarted, .hookProgress, .hookResponse,
         .taskStarted, .taskProgress, .authStatus,
         .filesPersisted, .localCommandOutput,
         .promptSuggestion, .toolUseSummary:
                             SystemEventView(event: event)
    case .unknown:           UnknownEventView(event: event)
    }
}
几个值得说的分派逻辑:
partialMessage 渲染为 EmptyView。 流式文本不走 ForEach(events),而是在 LazyVStack 下方用单独的 StreamingTextView 渲染。原因在第 1 篇讲过——partialMessage 只累积在 streamingText 里,不进 events 数组。这样避免了 ForEach 频繁插入/删除带来的闪烁和性能开销。
toolUse 走 toolCardView,toolResult/toolProgress 走 pairedToolEventView。 如果 toolContentMap 里有对应的条目(说明已经收到了配对的 toolUse),toolUse 渲染为 ToolCardView,配对的 toolResult/toolProgress 渲染为 EmptyView——因为它们的内容已经合并在卡片里了。如果 toolContentMap 里没有(比如历史事件加载不完整),就 fallback 到简单的 ToolCallView/ToolResultView。
system 类型需要区分"思考中"和普通系统事件。 systemOrThinking 方法检查 metadata 里的 subtype:
private func systemOrThinking(event: AgentEvent) -> some View {
    let subtype = event.metadata["subtype"] as? String ?? ""
    let isLastEvent = agentBridge.events.last?.id == event.id
    if (subtype == "init" || subtype == "status") && isLastEvent {
        ThinkingView()              // 旋转齿轮 + "思考中..."
    } else if subtype == "init" || subtype == "status" {
        ThinkingView(isActive: false) // 对勾 + "Agent 已响应"
    } else if let isError = event.metadata["isError"] as? Bool, isError {
        SystemEventView(event: event, isError: true)  // 红色错误条
    } else {
        SystemEventView(event: event)  // 普通系统消息
    }
}
只有最后一条 init/status 事件才显示旋转动画。历史事件显示静态的"Agent 已响应"。这避免了所有历史思考状态都在转圈的问题。
各事件视图的设计
UserMessageView——右对齐蓝色气泡
struct UserMessageView: View {
    let event: AgentEvent
    var body: some View {
        HStack {
            Spacer()
            Text(event.content)
                .padding(.horizontal, 12)
                .padding(.vertical, 8)
                .background(.blue.opacity(0.15))
                .clipShape(RoundedRectangle(cornerRadius: 12))
        }
    }
}
用户消息右对齐,蓝色半透明背景,圆角矩形。跟 ChatGPT 的消息布局一致。
AssistantMessageView——左侧竖线 + Markdown
struct AssistantMessageView: View {
    let event: AgentEvent
    var body: some View {
        HStack(alignment: .top, spacing: 0) {
            RoundedRectangle(cornerRadius: 1)
                .fill(Color.secondary.opacity(0.3))
                .frame(width: 2)
                .padding(.trailing, 8)
            MarkdownContentView(markdown: event.content)
            Spacer()
        }
    }
}
左边一条灰色竖线做视觉分隔,内容用 MarkdownContentView 渲染。这个组件处理 Markdown 解析、代码高亮和长文本折叠,第 4 篇会详细讲。
ThinkingView——旋转齿轮动画
struct ThinkingView: View {
    var isActive: Bool = true
    @State private var isAnimating = false

    var body: some View {
        HStack(spacing: 8) {
            if isActive {
                Image(systemName: "gearshape")
                    .rotationEffect(.degrees(isAnimating ? 360 : 0))
                    .animation(.linear(duration: 1).repeatForever(autoreverses: false),
                               value: isAnimating)
                Text("思考中...")
            } else {
                Image(systemName: "checkmark.circle")
                Text("Agent 已响应")
            }
            Spacer()
        }
        .onAppear { if isActive { isAnimating = true } }
    }
}
isActive 控制两种状态:旋转齿轮表示正在思考,绿色对勾表示思考完成。onAppear 触发动画,视图滚出屏幕再滚回来时不会重新触发。
ResultView——执行结果 + 统计数据
struct ResultView: View {
    let event: AgentEvent
    // 从 metadata 提取 durationMs、totalCostUsd、numTurns
    var body: some View {
        HStack(spacing: 4) {
            Image(systemName: statusIcon)  // checkmark.circle / pause.circle / xmark.circle
                .foregroundStyle(statusColor)
            Text(subtype)  // success / cancelled / error
        }
        // 下方显示:耗时 | 轮数 | 费用
        HStack(spacing: 12) {
            Label("\(duration)ms", systemImage: "clock")
            Label("\(turns) 轮", systemImage: "arrow.triangle.2.circlepath")
            Label(String(format: "$%.4f", cost), systemImage: "dollarsign.circle")
        }
    }
}
Result 事件显示执行结果的概要统计——耗时多少毫秒、经过多少轮对话、花费多少美元。错误时红底高亮。
SystemEventView——系统消息和错误提示
struct SystemEventView: View {
    let event: AgentEvent
    let isError: Bool

    var body: some View {
        HStack(spacing: 4) {
            if isError {
                RoundedRectangle(cornerRadius: 1).fill(Color.red).frame(width: 3)
                Image(systemName: "exclamationmark.triangle.fill").foregroundStyle(.red)
            } else {
                Image(systemName: "info.circle").foregroundStyle(.secondary)
            }
            Text(event.content)
        }
        .background(isError ? Color.red.opacity(0.08) : Color.clear)
    }
}
普通系统消息一行灰色文字 + info 图标。错误消息加红色左边条 + 红色背景 + 警告图标。
滚屏行为:Follow Latest vs Manual Browse
Agent 在执行时会持续产出事件。用户通常想看到最新的事件(自动滚到底部),但有时候想往上翻看历史。这两个需求是冲突的。
SwiftWork 用 ScrollModeManager 管理两种模式的切换:
enum ScrollMode {
    case followLatest    // 自动跟随最新事件
    case manualBrowse    // 用户手动浏览历史
}

@MainActor
@Observable
final class ScrollModeManager {
    var scrollMode: ScrollMode = .followLatest

    var showReturnToBottomButton: Bool {
        scrollMode == .manualBrowse
    }

    private let nearBottomThreshold: CGFloat = 96
    private let scrollUpThreshold: CGFloat = 16
    private var cumulativeUpwardDelta: CGFloat = 0
}
自动跟随的条件: 当用户距底部不超过 96pt 时,自动切回 followLatest。每次新事件到来,TimelineView 自动滚到底部。
切到手动浏览的条件: 用户向上滚动超过 16pt 时,切到 manualBrowse。此时新事件不再触发自动滚动,右下角显示"回到底部"按钮。
// TimelineView.swift
.onChange(of: agentBridge.events.count) { _, newCount in
    updateVisibleRangeForCount(newCount)
    if scrollModeManager.scrollMode == .followLatest {
        scrollToLast(proxy: proxy)
    }
}
.onChange(of: agentBridge.streamingText) { _, _ in
    if scrollModeManager.scrollMode == .followLatest {
        scrollToLast(proxy: proxy)
    }
}
两个 onChange 监听事件数量变化和流式文本变化。只有在 followLatest 模式下才自动滚动。
回到底部按钮: 点击后切回 followLatest,更新 visibleRange 到最新 50 条事件,动画滚到底部:
Button {
    scrollModeManager.returnToBottom()
    let total = agentBridge.events.count
    let lower = max(0, total - 50)
    visibleRange = lower..<total
    withAnimation {
        proxy.scrollTo("bottom-anchor", anchor: .bottom)
    }
}
虚拟化:只渲染可见范围
当事件数量超过几百条时,全部渲染会导致 LazyVStack 创建大量视图,滚动掉帧。SwiftWork 用 visibleRange + renderBuffer 做虚拟化——只渲染可见区域附近的 ±20 条事件。
@MainActor
final class TimelineVirtualizationManager {
    let renderBuffer = 20

    func eventsToRender(visibleRange: Range<Int>, allEvents: [AgentEvent]) -> [AgentEvent] {
        guard !allEvents.isEmpty else { return [] }
        let lower = max(0, visibleRange.lowerBound - renderBuffer)
        let upper = min(allEvents.count, visibleRange.upperBound + renderBuffer)
        guard lower < upper else { return [] }
        return Array(allEvents[lower..<upper])
    }
}
传入 ForEach 的不是 agentBridge.events,而是 virtualizedEvents——经过虚拟化裁剪后的子集:
private var virtualizedEvents: [AgentEvent] {
    let allEvents = agentBridge.events
    if allEvents.isEmpty { return [] }
    if visibleRange.isEmpty {
        let upper = allEvents.count
        let lower = max(0, upper - 50)
        return virtualizationManager.eventsToRender(visibleRange: lower..<upper, allEvents: allEvents)
    }
    return virtualizationManager.eventsToRender(visibleRange: visibleRange, allEvents: allEvents)
}
被裁掉的区域用占位符撑高度,保持滚动条的位置准确:
private var topPlaceholder: some View {
    let upper = max(0, visibleRange.lowerBound - virtualizationManager.renderBuffer)
    return Group {
        if upper > 0 && !visibleRange.isEmpty {
            Spacer().frame(height: CGFloat(upper) * estimatedRowHeight)
        }
    }
}
estimatedRowHeight 取 80pt——一个经验值,大部分事件视图的高度在这个范围附近。不需要精确,只需要让滚动条的大致位置正确。
visibleRange 的更新时机
visibleRange 在几个关键时刻更新:
- 初始加载(
.task(id: agentBridge.events.first?.id)):设为最后 50 条事件 - 新事件到来(
.onChange(of: events.count)):如果在followLatest模式,滑动窗口保持最新 50 条 - 回到底部:重置为最新 50 条
目前没有实现滚动过程中的 visibleRange 动态更新——用户向上滚动浏览大量历史事件时,visibleRange 不会跟着滚动位置变化。这是一个已知的限制,将来可以通过 onAppear/onDisappear 回调或 ScrollView 的 offset 监听来实现。
初始滚动:解决首次加载的闪烁
首次加载事件列表时,SwiftUI 的 ScrollView 默认从顶部开始渲染。如果会话有几百条事件,用户会先看到顶部的事件,然后闪一下跳到底部。这个闪烁在每次切换会话时都会出现。
SwiftWork 的解决方案:延迟 150ms 后再滚动到底部,等 LazyVStack 完成首屏渲染:
.task(id: agentBridge.events.first?.id) {
    hasCompletedInitialScroll = false
    guard !agentBridge.events.isEmpty else { return }
    scrollModeManager.scrollMode = .followLatest
    visibleRange = 0..<0
    try? await Task.sleep(for: .milliseconds(150))
    guard !Task.isCancelled else { return }
    let total = agentBridge.events.count
    let lower = max(0, total - 50)
    visibleRange = lower..<total
    withAnimation {
        proxy.scrollTo("bottom-anchor", anchor: .bottom)
    }
    hasCompletedInitialScroll = true
}
hasCompletedInitialScroll 标记位控制后续的滚动模式切换——在初始滚动完成之前,onChange(of: scrollPositionId) 不会触发模式切换,避免干扰。
总结
TimelineView 的设计可以概括为三个子系统:
| 子系统 | 解决的问题 | 实现 |
|---|---|---|
| 事件分派 | 18 种类型到 8 种视图 | eventView(for:) + ViewBuilder |
| 滚屏控制 | 自动跟随 vs 手动浏览 | ScrollModeManager + scrollPosition |
| 虚拟化 | 大量事件时的渲染性能 | visibleRange + renderBuffer + 占位符 |
事件分派是纯粹的视图逻辑——根据 event.type 选择对应的视图组件。滚屏控制和虚拟化是 TimelineView 独有的性能问题,跟 SDK 集成层无关。
下一篇看 Tool Card 系统——ToolRenderable 协议怎么让每种工具有自己的渲染器,以及 ToolRendererRegistry 怎么做到不改动时间线代码就能新增工具类型。
系列文章:
- 第 0 篇:用 SwiftUI 构建一个 Agent 可视化工作台
- 第 1 篇:SDK 集成层——把 AsyncStream 接进 SwiftUI
- 第 2 篇:事件时间线——18 种事件的可视化与性能(本文)
- 第 3 篇:Tool Card——可扩展的工具可视化系统
- 第 4 篇:数据层与服务——SwiftData、状态恢复与 Markdown 渲染
相关链接:
- SwiftWork:terryso/SwiftWork
- Open Agent SDK:terryso/open-agent-sdk-swift